 www.matefilia.it
 dal 2001
home > unità didattiche > variabili aleatorie discrete DSA
LE VARIABILI ALEATORIE DISCRETE
(Versione DSA)
Distribuzioni di probabilità, valori caratteristici ed esempi svolti
Questa pagina presuppone la conoscenza degli strumenti di base del calcolo delle probabilità (probabilità classica, totale, composta, condizionata, teorema di Bayes), trattati nella pagina Calcolo delle probabilità (DSA): se hai bisogno di ripassarli, ti consigliamo di consultarla prima di proseguire.
Qui costruiamo la teoria delle variabili aleatorie discrete: dopo aver definito la distribuzione di probabilità, la funzione di ripartizione e i valori caratteristici (valore atteso, varianza, deviazione standard), studiamo le distribuzioni discrete più importanti: uniforme discreta, binomiale, Poisson, geometrica e ipergeometrica.
💡 Per una visualizzazione ottimale dei grafici e delle formule, se stai usando lo smartphone disponilo orizzontalmente.
Clicca su ciascuna sezione per aprirla o chiuderla. Puoi tenere aperte più sezioni contemporaneamente.
Una variabile aleatoria (v.a.) \(X\) è una funzione che associa a ogni esito di un esperimento casuale un numero reale: \(X: \Omega \to \mathbb{R}\), dove \(\Omega\) è lo spazio campionario. Una variabile aleatoria si dice discreta quando può assumere soltanto un numero finito, o al più un'infinità numerabile, di valori \(x_1, x_2, x_3, \dots\)
Distribuzione di probabilità
La distribuzione di probabilità (o funzione di probabilità) di una v.a. discreta \(X\) è la funzione che associa a ciascun valore \(x_i\) la probabilità che \(X\) assuma proprio quel valore:
Perché questa sia una distribuzione di probabilità valida, devono valere le due proprietà che già conosciamo dagli assiomi della probabilità:
Una distribuzione di probabilità si rappresenta spesso con una tabella (valori \(x_i\) sulla prima riga, probabilità \(P_X(x_i)\) sulla seconda) oppure con un grafico a barre.
Esempio — La distribuzione di probabilità del lancio di un dado
Si lancia un dado a sei facce non truccato e si osserva il numero uscito \(X\). Qual è la distribuzione di probabilità di \(X\)?
Per la definizione classica, ciascuna faccia ha probabilità \(\frac{1}{6}\):
| \(x_i\) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| \(P_X(x_i)\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) |
Verifica: \(\sum_i P_X(x_i) = 6 \cdot \frac{1}{6} = 1\), come richiesto.
Funzione di ripartizione
La funzione di ripartizione (Cumulative Distribution Function, CDF) di una v.a. discreta \(X\), indicata con \(F_X(x)\), esprime la probabilità che \(X\) assuma un valore minore o uguale a \(x\):
Per una v.a. discreta, \(F_X(x)\) è una funzione a gradini: resta costante tra un valore possibile di \(X\) e il successivo, e "salta" (di un'altezza pari a \(P_X(x_i)\)) in corrispondenza di ogni valore \(x_i\) che \(X\) può assumere. Vale sempre \(0 \leq F_X(x) \leq 1\), con \(F_X(x) \to 0\) per \(x \to -\infty\) e \(F_X(x) \to 1\) per \(x \to +\infty\).
Esempio — La funzione di ripartizione del lancio di un dado
Con la stessa v.a. \(X\) dell'esempio precedente, determina e rappresenta graficamente \(F_X(x)\).
Sommando via via le probabilità:
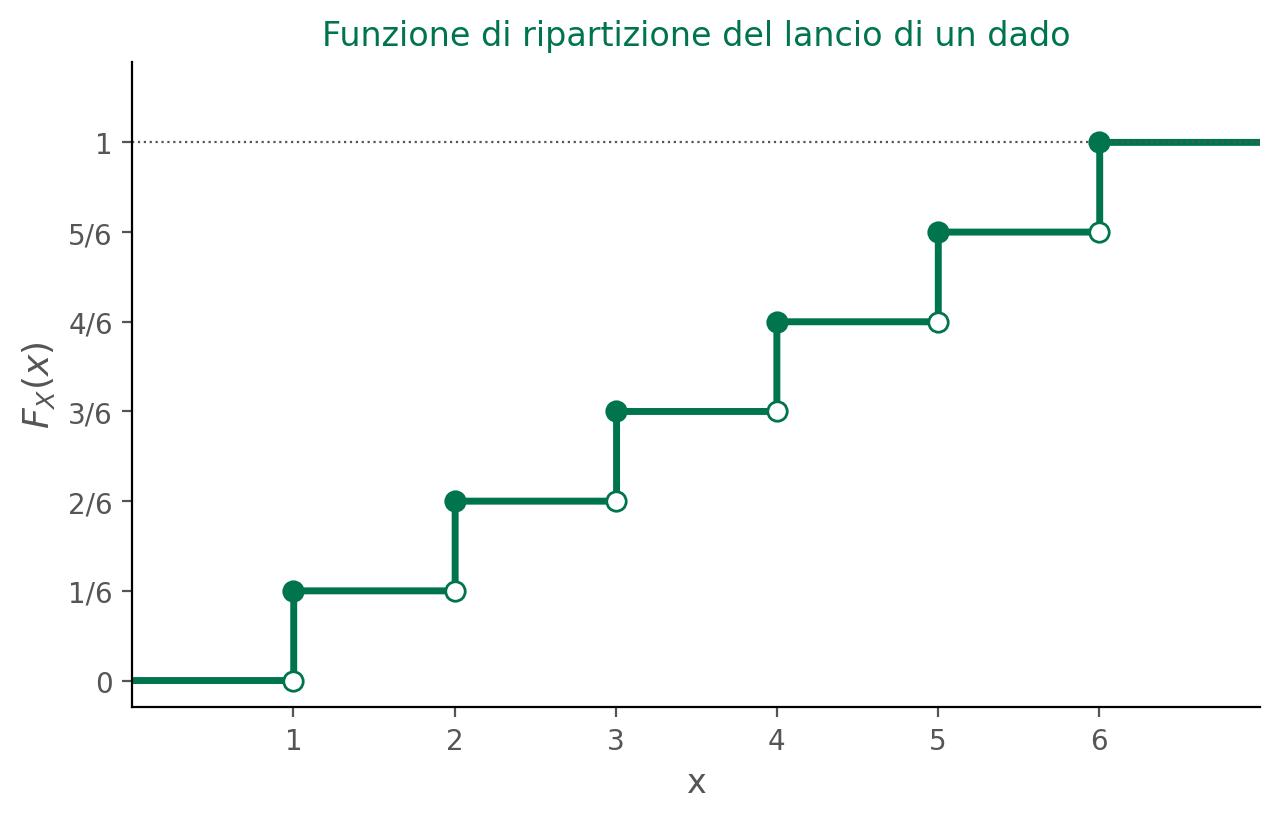
Ad esempio, \(F_X(3.5) = \frac{3}{6} = \frac{1}{2}\): la probabilità che esca un numero minore o uguale a 3.5 (cioè minore o uguale a 3, dato che \(X\) è intera) è del 50%.
Esempio — Il numero di teste in due lanci di una moneta
Si lancia due volte una moneta equilibrata e si osserva il numero di teste ottenute, \(X\). Rappresenta la distribuzione di probabilità di \(X\) mediante una tabella, un diagramma a canne e un istogramma. Determina inoltre la forma analitica e il grafico della funzione di ripartizione \(F_X(x)\).
Lo spazio campionario dell'esperimento (lancio di due monete) è \(\Omega = \{TT, TC, CT, CC\}\), con 4 esiti equiprobabili. La v.a. \(X\) conta il numero di teste in ciascun esito: \(X(TT) = 2\), \(X(TC) = X(CT) = 1\), \(X(CC) = 0\). Quindi \(X\) può assumere i valori \(0, 1, 2\), con
Tabella della distribuzione di probabilità:
| \(x_i\) | 0 | 1 | 2 |
|---|---|---|---|
| \(P_X(x_i)\) | \(\frac{1}{4}\) | \(\frac{1}{2}\) | \(\frac{1}{4}\) |
Verifica: \(\frac{1}{4} + \frac{1}{2} + \frac{1}{4} = 1\), come richiesto.
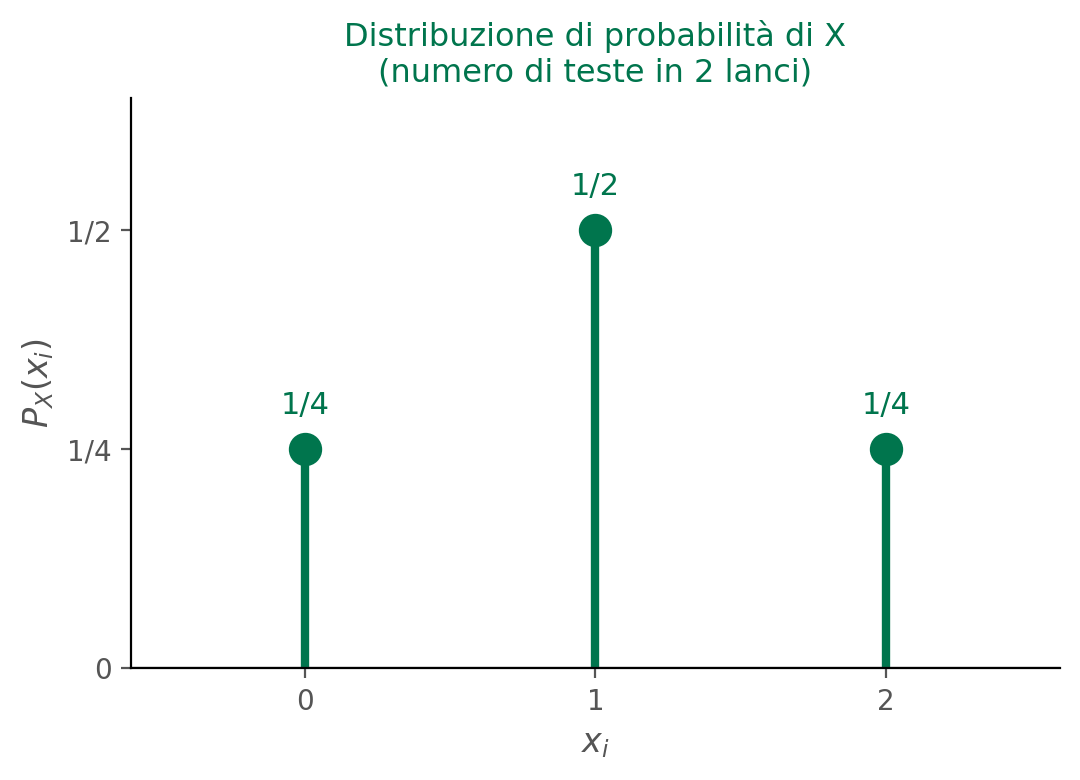
Diagramma a canne (a differenza del grafico a barre, ogni valore è rappresentato da un segmento verticale con un pallino in cima, non da un rettangolo):
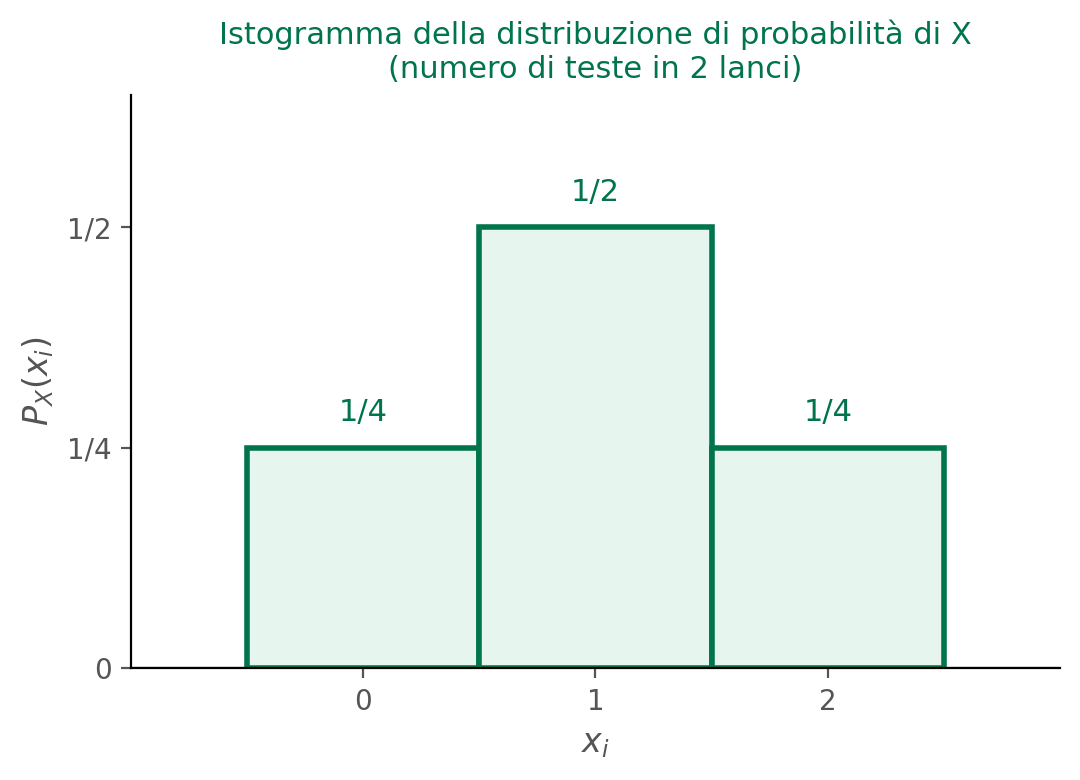
Istogramma: è un'altra rappresentazione possibile, in cui ogni valore \(x_i\) è associato a una barra di base 1 (centrata in \(x_i\)) e altezza \(P_X(x_i)\). Con questa scelta della base, l'area di ciascuna barra coincide numericamente con la sua altezza, cioè con la probabilità \(P_X(x_i)\): un modo di leggere la probabilità come area, anziché come semplice altezza, che tornerà utile più avanti.
Funzione di ripartizione, sommando via via le probabilità:
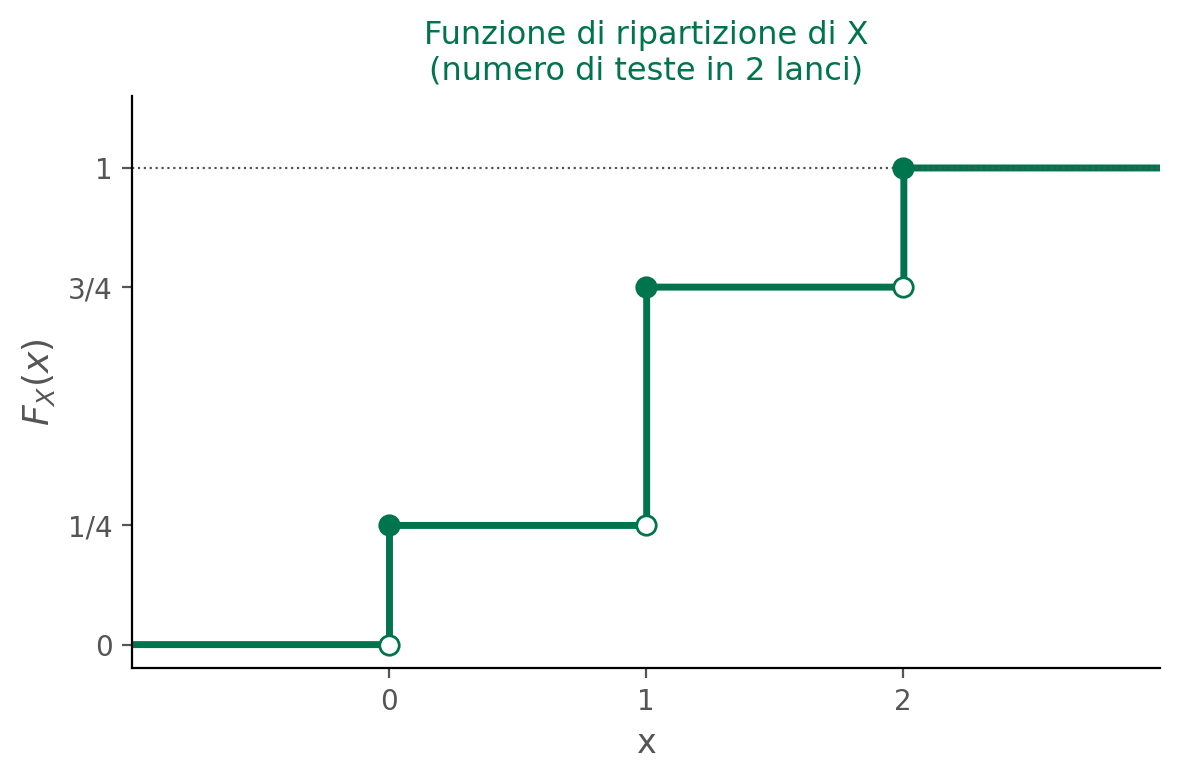
Si noti che il salto della funzione di ripartizione in corrispondenza di ciascun valore \(x_i\) è sempre pari a \(P_X(x_i)\): ad esempio, il salto in \(x=1\) è \(\frac{3}{4} - \frac{1}{4} = \frac{1}{2} = P_X(1)\), coerentemente.
La distribuzione di probabilità e la funzione di ripartizione descrivono \(X\) in modo completo: conoscendole, sappiamo tutto ciò che c'è da sapere sul comportamento della variabile aleatoria. Ma una tabella, o un grafico, non sono sempre il modo più comodo per confrontare variabili aleatorie diverse, o per farsi rapidamente un'idea di come si comporta \(X\) "in media". Per questo si introducono alcuni valori caratteristici: pochi numeri che riassumono gli aspetti più importanti di una distribuzione, in particolare attorno a quale valore \(X\) tende a concentrarsi (il valore atteso) e quanto i suoi valori tendono a disperdersi attorno a esso (la varianza, o la sua radice, la deviazione standard). Li vediamo nella prossima sezione.
Valore atteso
Il valore atteso di una v.a. discreta \(X\) — detto anche valor medio o speranza matematica — è il valore "medio" che ci aspettiamo di osservare, ripetendo l'esperimento un gran numero di volte, ponderando ciascun valore possibile con la probabilità con cui si presenta. Si indica con \(E[X]\) (dall'inglese expected value; nei testi italiani si trova spesso anche la notazione \(M[X]\) — nel seguito useremo \(E[X]\)).
Per capire bene perché si tratta di una media pesata, scriviamo la definizione nella forma generale di una media aritmetica ponderata, con i pesi \(p_i\) al denominatore:
Ma il denominatore \(p_1 + p_2 + \dots + p_n\) è proprio \(\sum_i P_X(x_i)\), che vale sempre 1 (è una delle due proprietà fondamentali di ogni distribuzione di probabilità, vista nella Sezione 0): il denominatore "scompare", e resta la formula che useremo sempre — scritta prima in forma estesa e poi con il simbolo di sommatoria:
È, in un certo senso, una media pesata dei valori possibili di \(X\), dove i pesi sono le rispettive probabilità (al posto delle frequenze relative usate nella media aritmetica classica).
Esempio — Valore atteso del lancio di un dado
Calcola il valore atteso della v.a. \(X\) = "numero uscito nel lancio di un dado a sei facce" (vista nella Sezione 0).
Il valore atteso è 3.5 — un valore che, non a caso, il dado non può mai assumere realmente: \(E[X]\) è una media teorica, non necessariamente uno dei valori possibili di \(X\).
Esempio — Valore atteso del numero di teste in due lanci
Calcola il valore atteso della v.a. \(X\) = "numero di teste in due lanci di una moneta" (vista nella Sezione 0).
In media, lanciando due volte una moneta, ci aspettiamo 1 testa — risultato intuitivo, dato che ogni singolo lancio ha probabilità \(\frac{1}{2}\) di dare testa.
Varianza e deviazione standard
Il valore atteso da solo non basta a descrivere come si comporta \(X\): due variabili aleatorie possono avere lo stesso \(E[X]\) ma "disperdersi" attorno a esso in modo molto diverso (una sempre vicina alla media, l'altra con valori molto lontani). La varianza misura proprio questo: è la media pesata dei quadrati degli scarti di \(X\) dal proprio valore atteso \(E[X]\):
Si eleva al quadrato lo scarto \((X - E[X])\) per due motivi: evitare che scarti positivi e negativi si compensino a vicenda nella somma (dando l'illusione di dispersione nulla), e dare più peso agli scarti grandi rispetto a quelli piccoli.
Questa formula, pur essendo la definizione più naturale, è scomoda da usare nei calcoli. Sviluppiamo il quadrato, ponendo per brevità \(\mu = E[X]\) (una costante):
(Nel passaggio abbiamo usato la linearità del valore atteso, \(E[aX+b] = a \, E[X] + b\), e il fatto che \(E[X] = \mu\).) Arriviamo così alla formula alternativa, equivalente alla definizione ma molto più comoda nei calcoli pratici:
Poiché la varianza è espressa in unità "al quadrato" rispetto a \(X\) (poco intuitive: ad esempio, se \(X\) fosse misurata in metri, \(\text{Var}(X)\) sarebbe in metri quadrati), si introduce anche la deviazione standard \(\sigma_X\) — detta anche scarto quadratico medio — definita come la radice quadrata della varianza, nella stessa unità di misura di \(X\):
Esempio — Varianza e deviazione standard del lancio di un dado
Calcola varianza e deviazione standard della v.a. \(X\) = "numero uscito nel lancio di un dado", sapendo che \(E[X] = \frac{7}{2}\) (esempio precedente).
Calcoliamo prima \(E[X^2]\):
Applichiamo la formula:
Esempio — Varianza e deviazione standard del numero di teste
Calcola varianza e deviazione standard della v.a. \(X\) = "numero di teste in due lanci di una moneta", sapendo che \(E[X] = 1\) (esempio precedente).
Calcoliamo prima \(E[X^2]\):
Applichiamo la formula:
La deviazione standard più piccola rispetto al dado (\(0.707\) contro \(1.708\)) riflette il fatto che i valori di \(X\) sono più "raccolti" attorno alla media: qui \(X \in \{0,1,2\}\), un intervallo più stretto rispetto ai 6 valori possibili del dado.
Il valore atteso e il gioco equo
Nella pagina Calcolo delle probabilità abbiamo introdotto il concetto di gioco equo imponendo che il guadagno atteso dei due partecipanti si bilanciasse: \(p \cdot V = (1-p) \cdot C\), dove \(p\) è la probabilità di vincita, \(V\) è la vincita, \(C\) è la quota pagata. Ora che abbiamo a disposizione il valore atteso, possiamo esprimere la stessa idea in modo più diretto e generale.
Consideriamo la v.a. \(X\) = "guadagno netto del giocatore" in un gioco con due esiti: vincita netta di \(V\) con probabilità \(p\), oppure perdita della posta \(C\) (cioè un guadagno di \(-C\)) con probabilità \(1-p\). Il valore atteso di \(X\) è:
Il segno di \(E[X]\) ci dice subito chi ha, in media, il vantaggio nel gioco:
Si noti che la condizione \(E[X] = 0\) equivale esattamente alla condizione \(p \cdot V = (1-p) \cdot C\) vista nella pagina sul calcolo delle probabilità: non è un caso, sono la stessa idea espressa con due strumenti diversi.
Esempio — I tre casi, con lo stesso gioco del dado
Si lancia un dado a sei facce. Se esce 6 si vince \(V = 60\) euro; altrimenti si paga una quota \(C\). Analizza, al variare di \(C\), se il gioco è equo, favorevole o sfavorevole al giocatore, usando il valore atteso del guadagno netto \(X\).
Con \(p = \frac{1}{6}\) (probabilità di vincere) e \(V = 60\):
Caso \(C = 12\):
Esattamente il valore di \(C\) che avevamo trovato nella pagina sul calcolo delle probabilità, imponendo \(p \cdot V = (1-p) \cdot C\): il valore atteso conferma quel risultato con un metodo diverso.
Caso \(C = 6\) (quota più bassa, meno svantaggiosa per il giocatore):
In media, il giocatore guadagna 5 euro a partita: un gioco così, ripetuto molte volte, conviene a chi gioca (e sarebbe in perdita per chi lo propone).
Caso \(C = 18\) (quota più alta, più svantaggiosa per il giocatore):
In media, il giocatore perde 5 euro a partita: è il caso tipico dei giochi d'azzardo reali, dove le quote sono fissate in modo che \(E[X] < 0\) per il giocatore (e quindi \(E[X] > 0\) per il banco).
Esempio — Estrazione di due carte (conviene giocare?)
Da un mazzo di 40 carte (12 figure, 28 non figure) un giocatore sceglie a caso 2 carte contemporaneamente. Se sono entrambe figure vince 70 euro; se è figura una sola delle due vince 20 euro; se nessuna delle due è figura non vince nulla e perde la posta di 35 euro. Conviene giocare?
I casi possibili sono le combinazioni di 2 carte scelte tra 40: \(\binom{40}{2} = 780\). Calcoliamo le tre probabilità:
(Verifica: \(\frac{11}{130} + \frac{28}{65} + \frac{63}{130} = \frac{11+56+63}{130} = \frac{130}{130} = 1\), come deve essere.) Sia \(X\) il guadagno netto del giocatore:
In media si perde circa 2.42 euro a partita. A quanto dovrebbe ammontare la posta, lasciando invariate le vincite, perché il gioco fosse equo? Basta imporre \(E[X] = 0\) e risolvere rispetto a \(C\):
Con una posta di 30 euro (anziché 35) il gioco sarebbe equo. La posta proposta di 35 euro è quindi troppo alta rispetto alle probabilità di vincita: ecco perché il gioco, così com'è, non conviene al giocatore.
In che cosa consiste
La distribuzione uniforme discreta è il modello di probabilità più semplice e intuitivo. Si applica quando una variabile aleatoria discreta \(X\) può assumere un numero finito \(n\) di valori possibili, ciascuno dei quali ha esattamente la stessa probabilità di verificarsi. È il modello teorico di riferimento per tutti gli esperimenti aleatori "non truccati" o perfettamente bilanciati (lancio di una moneta, di un dado, estrazione di un numero da una ruota, ecc.).
Se la variabile aleatoria \(X\) assume i valori \(\{x_1, x_2, \dots, x_n\}\), la legge di probabilità è data da:
La funzione di ripartizione \(F(x)\)
La funzione di ripartizione (o funzione di distribuzione cumulata) misura la probabilità che la variabile aleatoria assuma un valore minore o uguale a un dato valore reale \(x\):
Per la distribuzione uniforme discreta, la funzione di ripartizione cresce "a gradini" (funzione a scala): parte da 0 per valori inferiori al valore minimo, aumenta di \(\frac{1}{n}\) in corrispondenza di ciascun valore possibile, e raggiunge 1 per tutti i valori maggiori o uguali al valore massimo.
Esempio 1 — Lancio di un dado a 6 facce (Valore atteso, varianza e grafici)
Consideriamo il lancio di un dado a 6 facce non truccato. Sia \(X\) la variabile aleatoria che indica il punteggio ottenuto.
I valori possibili sono \(x_i \in \{1, 2, 3, 4, 5, 6\}\), dunque \(n = 6\). Ciascun valore ha probabilità \(P(X = x_i) = \frac{1}{6}\).
| \(x_i\) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| \(P_X(x_i)\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) | \(\frac{1}{6}\) |
1. Calcolo del Valore Atteso \(E[X]\)
Applichiamo la definizione generale di valore atteso (\(E[X] = \sum x_i \cdot P_X(x_i)\)):
2. Calcolo della Varianza \(Var(X)\) e della Deviazione Standard \(\sigma\)
Calcoliamo prima il valore atteso dei quadrati \(E[X^2] = \sum x_i^2 \cdot P_X(x_i)\):
Usiamo ora la formula generale della varianza \(Var(X) = E[X^2] - (E[X])^2\):
La deviazione standard è lo scarto quadratico medio:
3. Grafico della Distribuzione di Probabilità e della Funzione di Ripartizione
Grafico della Distribuzione di Probabilità \(P_X(x_i)\):
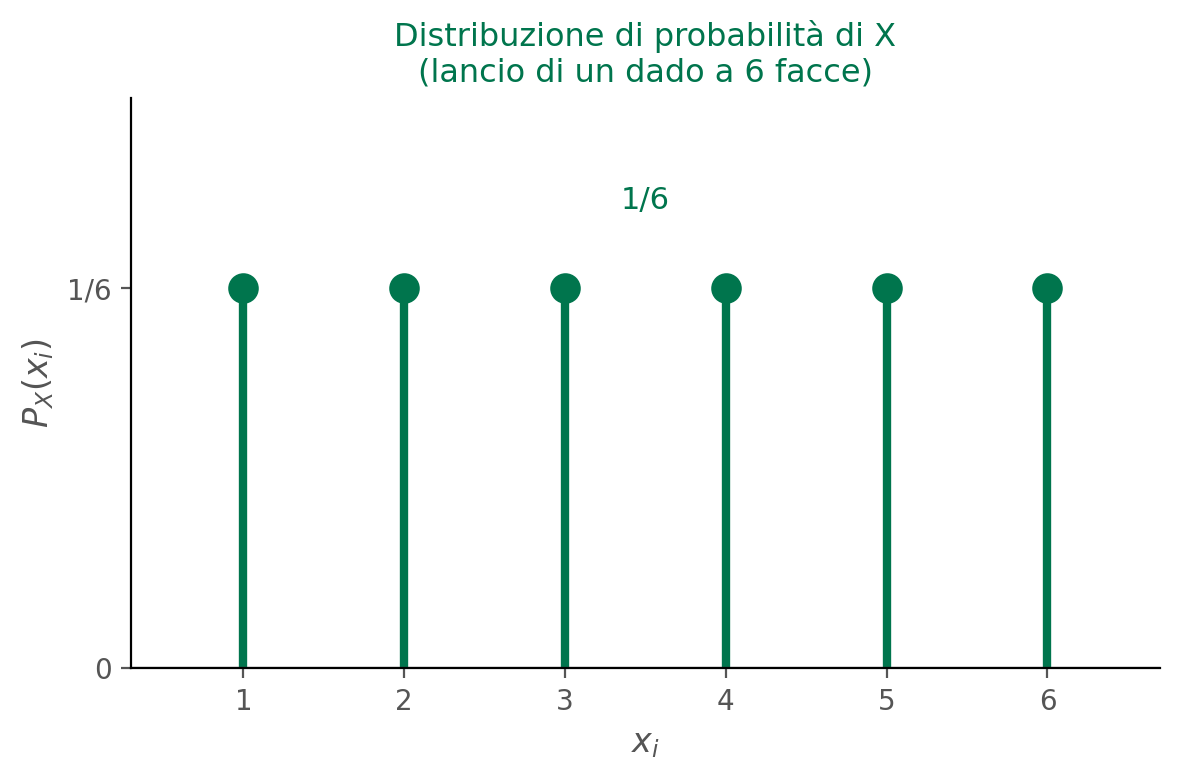
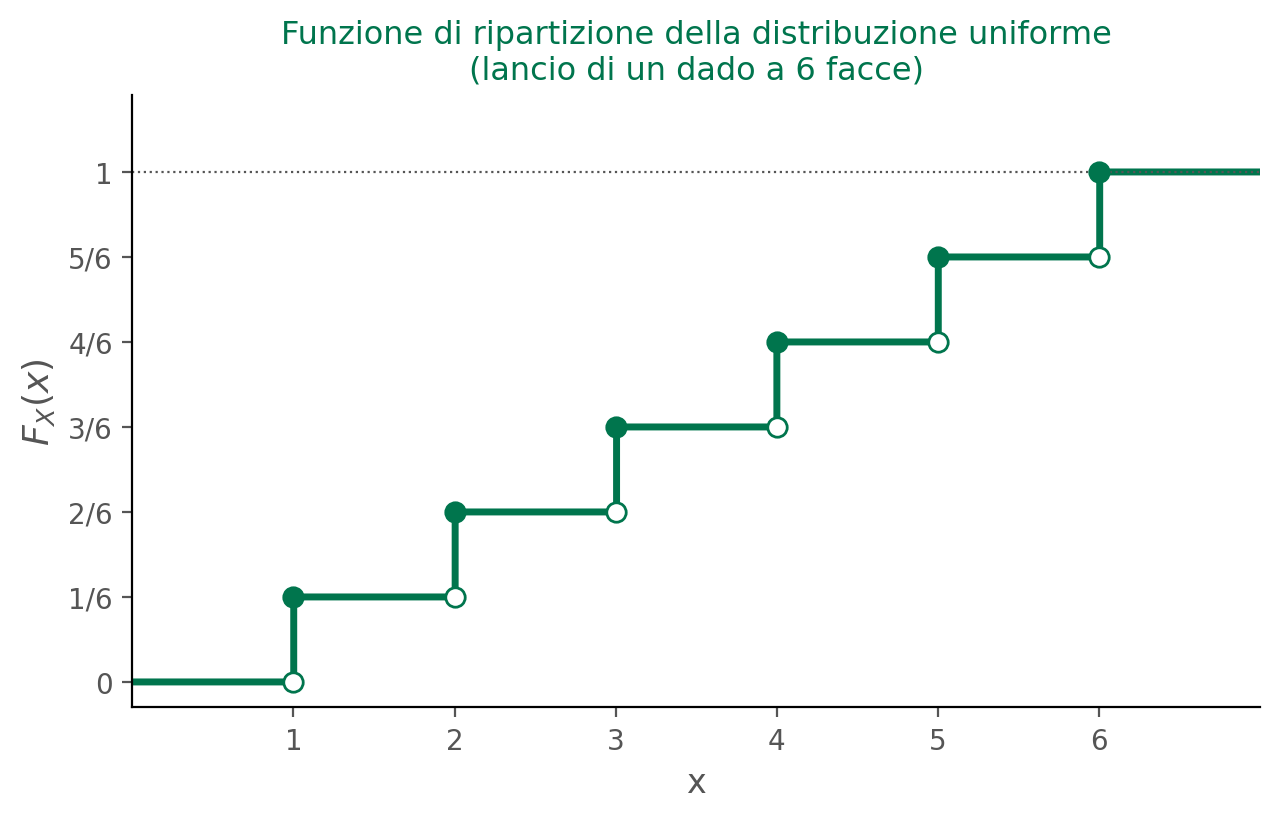
Grafico a gradini della Funzione di Ripartizione \(F_X(x) = P(X \leq x)\):
L'espressione analitica della funzione di ripartizione \(F_X(x)\) per il dado a 6 facce è definita a tratti:
Esempio 2 — Ruota della fortuna a 10 settori
Una ruota della fortuna è suddivisa in 10 settori uguali numerati da 1 a 10. Si fa girare la ruota e si indica con \(X\) il numero su cui si ferma la freccia. Qual è la probabilità che esca un numero maggiore o uguale a 7?
Qui il supporto della variabile aleatoria è \(\{1, 2, 3, 4, 5, 6, 7, 8, 9, 10\}\), con \(n = 10\). Ogni settore ha probabilità:
L'evento "ottenere un numero maggiore o uguale a 7" corrisponde all'insieme dei valori favorevoli \(\{7, 8, 9, 10\}\) (in totale 4 valori). Poiché i valori sono mutuamente esclusivi, sommiamo le singole probabilità:
Utilizzando la funzione di ripartizione e la regola del complementare:
Lo schema di Bernoulli
Nella pagina Calcolo delle probabilità (Sezione 4) avevamo calcolato la probabilità di ottenere esattamente 2 palline rosse su 3 estrazioni con reimmissione da un'urna, trovando \(\binom{3}{2} \cdot p^2 \cdot (1-p)\). Quello, di fatto, era già un esempio di distribuzione binomiale — qui la studiamo nella sua forma generale.
Una prova di Bernoulli è un esperimento casuale con due soli esiti possibili, convenzionalmente chiamati successo (probabilità \(p\)) e insuccesso (probabilità \(1-p\)). Se ripetiamo una prova di Bernoulli \(n\) volte, in modo indipendente e mantenendo sempre la stessa probabilità di successo \(p\), la variabile aleatoria
si dice che ha distribuzione binomiale di parametri \(n\) e \(p\).
Derivazione della formula
Calcoliamo \(P_X(k) = P(X=k)\), la probabilità di ottenere esattamente \(k\) successi su \(n\) prove, con lo stesso ragionamento già usato nell'esempio richiamato sopra:
1. Fissiamo un ordine specifico. Consideriamo, ad esempio, che i primi \(k\) risultati siano tutti successi e i restanti \(n-k\) siano tutti insuccessi. Per l'indipendenza delle prove, la probabilità di questa sequenza specifica è il prodotto delle singole probabilità:
2. Contiamo quanti ordini sono possibili. Non ci interessa solo quella sequenza specifica, ma tutte le sequenze di \(n\) prove che contengono esattamente \(k\) successi (in un ordine qualsiasi): sono tante quanti i modi di scegliere quali \(k\) prove, tra le \(n\), sono successi — cioè \(\binom{n}{k}\).
3. Sommiamo. Ciascuno di questi \(\binom{n}{k}\) ordini ha la stessa probabilità \(p^k(1-p)^{n-k}\) (il prodotto non dipende dall'ordine dei fattori) e sono eventi incompatibili tra loro (non può verificarsene più di uno). Per la probabilità totale, sommiamo:
Valore atteso e varianza
Una v.a. binomiale \(X\) (numero di successi su \(n\) prove) si può pensare come somma di \(n\) piccole variabili aleatorie più semplici: \(X = X_1 + X_2 + \dots + X_n\), dove \(X_i\) vale 1 se la \(i\)-esima prova è un successo, 0 altrimenti. Ciascun \(X_i\) ha \(E[X_i] = 1 \cdot p + 0 \cdot (1-p) = p\). Sfruttando una proprietà del valore atteso che generalizza la linearità già vista nella Sezione 1 — il valore atteso di una somma è la somma dei valori attesi, anche per più variabili insieme — si ottiene:
Con un ragionamento analogo (che sfrutta anche l'indipendenza delle prove, qui non dimostriamo nel dettaglio) si ottiene la varianza:
Verifichiamo che queste formule sono coerenti con la definizione diretta della Sezione 1, su un caso semplice: 3 lanci di una moneta equilibrata (\(n=3\), \(p=\frac{1}{2}\)), con \(X\) = numero di teste. La distribuzione di \(X\) è \(P_X(0)=\frac{1}{8}\), \(P_X(1)=\frac{3}{8}\), \(P_X(2)=\frac{3}{8}\), \(P_X(3)=\frac{1}{8}\). Calcolando direttamente: \(E[X] = 0\cdot\frac{1}{8}+1\cdot\frac{3}{8}+2\cdot\frac{3}{8}+3\cdot\frac{1}{8} = \frac{12}{8} = \frac{3}{2}\), che coincide con \(np = 3 \cdot \frac{1}{2} = \frac{3}{2}\). Analogamente si trova \(\text{Var}(X) = \frac{3}{4}\), che coincide con \(np(1-p) = 3 \cdot \frac{1}{2} \cdot \frac{1}{2} = \frac{3}{4}\): le formule generali funzionano.
Esempio facile — Il lancio ripetuto di un dado
Si lancia un dado a sei facce 5 volte. Qual è la probabilità di ottenere esattamente due 6?
Ogni lancio è una prova di Bernoulli con successo = "esce 6", probabilità \(p = \frac{1}{6}\); i lanci sono indipendenti. \(X\) = numero di 6 su \(n=5\) lanci è binomiale di parametri \(n=5\), \(p=\frac{1}{6}\). Applichiamo la formula con \(k=2\):
Esempio medio — Il quiz a risposta multipla (probabilità di "almeno uno")
Un quiz è composto da 5 domande, ciascuna con 4 possibili risposte di cui una sola corretta. Uno studente risponde a caso a tutte le domande, indipendentemente l'una dall'altra. Qual è la probabilità che indovini almeno una risposta?
Ogni domanda è una prova di Bernoulli con successo = "risposta corretta", \(p = \frac{1}{4}\); \(X\) = numero di risposte corrette su \(n=5\) domande è binomiale. Calcolare direttamente \(P(X \geq 1)\) richiederebbe di sommare \(P_X(1) + P_X(2) + \dots + P_X(5)\): conviene invece passare al complementare, \(X=0\) (nessuna risposta corretta):
Nonostante ogni singola domanda abbia solo il 25% di probabilità di essere indovinata, su 5 domande la probabilità di indovinarne almeno una sale a oltre il 76%.
Esempio applicativo — Pezzi difettosi in una linea di produzione
In una fabbrica (già incontrata nella pagina "Calcolo delle probabilità", Sezione 6, a proposito del teorema di Bayes) la linea di produzione A realizza pezzi meccanici con una percentuale di difettosità del 5%. Da questa linea si preleva un campione di 20 pezzi. Qual è il numero atteso di pezzi difettosi nel campione, e qual è la deviazione standard?
Ogni pezzo prelevato è una prova di Bernoulli con successo = "pezzo difettoso", \(p = \frac{5}{100} = 0.05\); \(X\) = numero di pezzi difettosi su \(n=20\) pezzi è binomiale (assumendo prelievi indipendenti, ad esempio con reimmissione, o un lotto molto grande rispetto al campione). Applichiamo le formule:
In un campione di 20 pezzi ci aspettiamo, in media, 1 pezzo difettoso, con una deviazione standard di circa 0.975 pezzi: un responsabile qualità saprebbe quindi che trovare 0, 1 o 2 pezzi difettosi in un controllo è del tutto normale, mentre un numero molto più alto (es. 5 o 6) sarebbe un segnale di allarme.
Motivazione: eventi rari nel tempo o nello spazio
Pensiamo al numero di clienti che arrivano a uno sportello in un'ora, al numero di chiamate ricevute da un centralino, o al numero di refusi in una pagina di un libro. Sono eventi che accadono "a caso" nel tempo o nello spazio, di cui conosciamo solo la media con cui si verificano (ad esempio: "in media 3 clienti all'ora"), ma manca un \(n\) naturale di "prove", come c'era invece nel lancio ripetuto di un dado.
L'idea, dovuta a Poisson, è questa: immaginiamo di suddividere l'ora in tantissimi intervallini piccolissimi (secondi, o frazioni di secondo). In ciascun intervallino può arrivare al più un cliente: è quasi una prova di Bernoulli, con una probabilità di successo \(p\) piccolissima. Se l'intervallino è abbastanza piccolo da averne \(n\) nell'ora, il numero di clienti arrivati è approssimativamente binomiale di parametri \(n\) e \(p\) — esattamente l'argomento della sezione precedente! Man mano che rendiamo gli intervallini sempre più piccoli (\(n \to \infty\) e, di conseguenza, \(p \to 0\)), mantenendo però fissa la media \(np = \lambda\) (il numero medio di clienti nell'ora), la distribuzione binomiale converge a una nuova distribuzione: la distribuzione di Poisson, di parametro \(\lambda\).
Derivazione della formula (come limite della binomiale)
Partiamo dalla formula della binomiale, e sostituiamo \(p = \frac{\lambda}{n}\) (in modo che \(np = \lambda\) resti costante mentre \(n\) cresce):
Riscriviamo raggruppando i termini che dipendono da \(n\):
Concentriamoci sul primo termine sottolineato, \(\dfrac{n!}{(n-k)! \, n^k}\). Scriviamo il fattoriale \(n!\) come \(1 \cdot 2 \cdots (n-k) \cdot (n-k+1) \cdots n\): i primi \(n-k\) fattori sono esattamente quelli di \((n-k)!\), che quindi si semplifica con il denominatore, lasciando al numeratore solo gli ultimi \(k\) fattori:
Il numeratore è un prodotto di \(k\) fattori consecutivi, ciascuno "vicino" a \(n\): è un polinomio in \(n\) di grado \(k\), il cui termine di grado massimo è \(n^k\) (esattamente come il denominatore). Per \(n \to \infty\), un polinomio di grado \(k\) si comporta come il suo termine di grado massimo: il numeratore "si comporta come" \(n^k\), e quindi il rapporto tende a 1 — stesso principio che si usa per i limiti di funzioni razionali, quando numeratore e denominatore hanno lo stesso grado.
Per il secondo termine sottolineato vale il limite notevole \(\left(1-\frac{\lambda}{n}\right)^n \to e^{-\lambda}\); per il terzo, l'esponente \(-k\) è fisso e la base tende a 1, quindi l'intero termine tende a 1. Restano solo \(\frac{\lambda^k}{k!}\) e \(e^{-\lambda}\):
Valore atteso e varianza
Sfruttiamo ancora il legame con la binomiale: sappiamo che, per essa, \(E[X] = np = \lambda\) (per costruzione) e \(\text{Var}(X) = np(1-p) = \lambda \left(1 - \frac{\lambda}{n}\right)\). Passando al limite per \(n \to \infty\) (con \(\lambda\) fisso), il fattore \(\left(1-\frac{\lambda}{n}\right) \to 1\), e quindi:
Un fatto notevole, facile da ricordare: per la distribuzione di Poisson, valore atteso e varianza coincidono (entrambi uguali al parametro \(\lambda\)).
Esempio facile — Le chiamate a un centralino
Un centralino riceve, in media, 2 chiamate ogni 10 minuti. Qual è la probabilità di ricevere esattamente 3 chiamate in un intervallo di 10 minuti?
Il numero di chiamate \(X\) in 10 minuti segue una distribuzione di Poisson di parametro \(\lambda = 2\) (la media data). Applichiamo la formula con \(k=3\):
Esempio medio — I refusi in una pagina (probabilità di "almeno uno")
In un libro, il numero di refusi per pagina segue una distribuzione di Poisson con media 0.5 refusi a pagina. Qual è la probabilità che una pagina scelta a caso contenga almeno un refuso?
Qui \(\lambda = 0.5\). Come nell'esempio del quiz nella sezione precedente, conviene passare al complementare, \(X=0\) (nessun refuso):
Quasi il 40% delle pagine contiene almeno un refuso, pur essendo la media di soli 0.5 refusi a pagina.
Esempio di collegamento — Quanto è buona l'approssimazione?
Riprendiamo l'esempio della linea di produzione A della sezione precedente (\(n=20\) pezzi, probabilità di difettosità \(p=0.05\)). Confronta la distribuzione binomiale esatta del numero di pezzi difettosi con l'approssimazione di Poisson di parametro \(\lambda = np\).
Calcoliamo \(\lambda = np = 20 \cdot 0.05 = 1\), e confrontiamo \(P_X(k)\) calcolata con la formula esatta della binomiale e con quella approssimata di Poisson, per alcuni valori di \(k\):
| \(k\) | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| Binomiale esatta | 35.85% | 37.74% | 18.87% | 5.96% | 1.33% |
| Poisson (\(\lambda=1\)) | 36.79% | 36.79% | 18.39% | 6.13% | 1.53% |
Le differenze sono minime (sempre inferiori all'1%), nonostante \(n=20\) non sia enorme: questo conferma che l'approssimazione di Poisson funziona bene già per \(n\) "ragionevolmente grande" e \(p\) "ragionevolmente piccolo" — non serve un \(n\) astronomico perché il limite calcolato sopra dia risultati praticamente affidabili. Questo rende la Poisson molto utile anche come approssimazione pratica della binomiale, quando \(n\) è grande e \(p\) è piccolo (i calcoli con la Poisson sono spesso più semplici, perché non richiedono il coefficiente binomiale \(\binom{n}{k}\)).
Motivazione: quante prove servono per il primo successo?
Nella distribuzione binomiale ci siamo chiesti: fissato il numero di prove \(n\), quanti successi otteniamo? Ora capovolgiamo la domanda: quante prove servono per ottenere il primo successo? È una domanda naturale in molti contesti concreti: quanti lanci di un dado servono per ottenere il primo 6? Quanti pezzi bisogna ispezionare, in una linea di produzione, prima di trovare il primo difettoso? Quante telefonate a freddo servono a un venditore prima della prima vendita?
Sia \(X\) il numero di prove di Bernoulli (indipendenti, con la stessa probabilità di successo \(p\)) necessarie per ottenere il primo successo. La variabile aleatoria \(X\) si dice che ha distribuzione geometrica di parametro \(p\).
Derivazione della formula
Perché il primo successo avvenga esattamente alla prova \(k\)-esima, servono \(k-1\) insuccessi consecutivi (ciascuno con probabilità \(1-p\)) seguiti da un successo (probabilità \(p\)). Per l'indipendenza delle prove, moltiplichiamo le probabilità — qui, a differenza della binomiale, l'ordine è fissato (prima tutti insuccessi, poi il successo), quindi non serve alcun coefficiente binomiale:
Verifichiamo che sia una distribuzione di probabilità valida, cioè che \(\sum_{k=1}^{\infty} P_X(k) = 1\). I valori \(P_X(1), P_X(2), P_X(3), \dots\) sono i termini di una progressione geometrica di primo termine \(a_1 = P_X(1) = p\) e ragione \(q = 1-p\) (ogni termine si ottiene moltiplicando il precedente per \(1-p\)). Richiamiamo la formula della somma dei primi \(n\) termini di una progressione geometrica:
Qui \(0 < q = 1-p < 1\) (essendo \(0<p<1\)), quindi \(q^n \to 0\) per \(n \to \infty\), e la somma tende a:
La somma di tutte le probabilità vale davvero 1: la distribuzione è coerente — e il nome "geometrica" prende senso proprio da questo legame con le progressioni geometriche.
Valore atteso e varianza
Il valore atteso e la varianza della distribuzione geometrica si calcolano con tecniche che vanno oltre gli scopi di questa pagina (richiedono di derivare termine a termine una somma infinita); ci limitiamo a enunciarli e a verificarli numericamente:
Verifica numerica, con \(p = \frac{1}{6}\) (il caso del dado): sommando direttamente \(\sum_{k} k \cdot P_X(k)\) sui primi 200 termini (i termini successivi sono ormai trascurabili, essendo \((1-p)^{k-1}\) piccolissimo) si ottiene \(E[X] \approx 6.000\), esattamente \(\frac{1}{p} = \frac{1}{1/6} = 6\). Analogamente si trova \(\text{Var}(X) \approx 30.000\), esattamente \(\frac{1-p}{p^2} = \frac{5/6}{1/36} = 30\): le formule sono confermate.
Una proprietà notevole: l'assenza di memoria
La distribuzione geometrica ha una proprietà sorprendente: non ha memoria del passato. Sapere di aver già fallito \(s\) volte non cambia la probabilità di dover aspettare ancora \(t\) prove per il successo — in un certo senso, "il dado non si ricorda" dei tiri precedenti. Formalmente:
Questa proprietà smentisce la cosiddetta fallacia dello scommettitore: l'illusione, molto diffusa, che dopo tanti insuccessi consecutivi il successo sia "più vicino" o "più probabile". Non è così: a ogni nuovo tentativo, la probabilità di successo resta sempre \(p\), indipendentemente da quanti fallimenti ci sono già stati. Un giocatore che pensa "ho perso 10 volte di fila, ora devo vincere" sta commettendo esattamente questo errore.
Esempio facile — Il primo 6 al terzo lancio
Si lancia ripetutamente un dado a sei facce. Qual è la probabilità che il primo 6 esca esattamente al terzo lancio?
\(X\) = numero di lanci fino al primo 6 è geometrica di parametro \(p=\frac{1}{6}\). Applichiamo la formula con \(k=3\):
Esempio medio — Al più 4 lanci per il primo 6
Si lancia ripetutamente un dado a sei facce. Qual è la probabilità che servano al più 4 lanci per ottenere il primo 6 (cioè che il primo 6 esca entro il quarto lancio)?
Conviene passare al complementare: \(X>4\) significa che nei primi 4 lanci non è mai uscito 6, cioè 4 insuccessi consecutivi:
C'è quindi poco più del 50% di probabilità di ottenere il primo 6 già entro i primi 4 tentativi.
Esempio di collegamento — Ispezioni fino al primo pezzo difettoso
Nella linea di produzione A già incontrata (percentuale di difettosità del 5%), i pezzi vengono ispezionati uno alla volta. Qual è il numero atteso di ispezioni necessarie per trovare il primo pezzo difettoso, e qual è la deviazione standard?
Il numero di ispezioni \(X\) fino al primo pezzo difettoso è geometrico di parametro \(p=0.05\). Applichiamo le formule:
In media servono 20 ispezioni per trovare il primo pezzo difettoso — coerente con il fatto che, su un campione di 20 pezzi (Sezione 3), ci aspettavamo in media esattamente 1 pezzo difettoso. La deviazione standard molto grande (quasi 19.5) segnala però che il numero di ispezioni necessarie può variare moltissimo da un caso all'altro: a volte basta 1 ispezione, altre volte potrebbero servirne molte decine.
In che cosa consiste
Nella pagina Calcolo delle probabilità avevamo distinto le estrazioni con reimmissione (probabilità costante a ogni estrazione, eventi indipendenti) da quelle senza reimmissione (probabilità che cambia via via, eventi dipendenti). La distribuzione binomiale, vista nella Sezione 3, presuppone prove indipendenti: è quindi il modello corretto per le estrazioni con reimmissione. Quando invece estraiamo senza reimmissione da una popolazione finita, serve un modello diverso: la distribuzione ipergeometrica.
Supponiamo di avere una popolazione di \(N\) elementi, di cui \(K\) "favorevoli" (ad esempio, palline rosse in un'urna) e i restanti \(N-K\) "non favorevoli". Si estraggono simultaneamente \(n\) elementi (equivalente a estrarli uno alla volta senza rimetterli). Sia \(X\) il numero di elementi favorevoli nel campione estratto: \(X\) ha distribuzione ipergeometrica, di parametri \(N\), \(K\), \(n\), con:
La logica è la stessa combinatoria già vista tante volte: al numeratore si scelgono i \(k\) elementi favorevoli tra i \(K\) disponibili e i restanti \(n-k\) elementi del campione tra gli \(N-K\) non favorevoli; al denominatore ci sono tutti i modi possibili di scegliere \(n\) elementi tra gli \(N\) totali.
Esempio facile — Estrazione da un'urna
Un'urna contiene 10 palline, di cui 6 rosse e 4 blu. Si estraggono simultaneamente 3 palline. Qual è la probabilità di ottenere esattamente 2 palline rosse?
Metodo 1 — Con la formula della distribuzione ipergeometrica
Applichiamo direttamente la formula ponendo \(N=10\), \(K=6\) (rosse), \(n=3\), \(k=2\):
Metodo 2 — Casi favorevoli / Casi possibili (definizione classica)
Possiamo calcolare la probabilità come rapporto tra il numero di terne favorevoli e il numero totale di terne possibili:
- Casi possibili: i modi in cui possiamo scegliere 3 palline qualunque tra le 10 disponibili, ossia le combinazioni di 10 oggetti a 3 a 3: \[ \text{Casi possibili} = \binom{10}{3} = \frac{10 \cdot 9 \cdot 8}{3 \cdot 2 \cdot 1} = 120. \]
- Casi favorevoli: dobbiamo scegliere 2 palline rosse tra le 6 presenti (combinazioni di 6 oggetti a 2 a 2) e 1 pallina blu tra le 4 presenti (combinazioni di 4 oggetti a 1 a 1): \[ \text{Casi favorevoli} = \binom{6}{2} \cdot \binom{4}{1} = 15 \cdot 4 = 60. \]
La probabilità è dunque:
Metodo 3 — Ragionamento sequenziale (senza combinatoria)
Estrarre 3 palline simultaneamente equivale a estrarle una dopo l'altra senza reimmissione. Calcoliamo la probabilità di ottenere una sequenza specifica, ad esempio (Rossa, Rossa, Blu):
- 1ª pallina Rossa: \(\frac{6}{10}\)
- 2ª pallina Rossa: \(\frac{5}{9}\) (rimangono 5 rosse su 9 totali)
- 3ª pallina Blu: \(\frac{4}{8}\) (rimangono 4 blu su 8 totali)
La probabilità di questa specifica sequenza è:
Le 2 palline rosse e la blu possono uscire in 3 ordini diversi ugualmente probabili: (R, R, B), (R, B, R) e (B, R, R). Quindi la probabilità totale è:
Esempio medio — Estrazione di carte
Da un mazzo di 40 carte (12 figure) si estraggono simultaneamente 5 carte. Qual è la probabilità di ottenere esattamente 2 figure?
Metodo 1 — Con la formula della distribuzione ipergeometrica
Applichiamo la formula ponendo \(N=40\), \(K=12\) (figure), \(n=5\), \(k=2\):
Metodo 2 — Casi favorevoli / Casi possibili (definizione classica)
Ragionando per combinazioni:
- Casi possibili: i modi di scegliere 5 carte qualsiasi tra le 40 del mazzo (combinazioni di 40 elementi a 5 a 5): \[ \text{Casi possibili} = \binom{40}{5} = \frac{40 \cdot 39 \cdot 38 \cdot 37 \cdot 36}{5 \cdot 4 \cdot 3 \cdot 2 \cdot 1} = 658\,008. \]
- Casi favorevoli: dobbiamo scegliere 2 figure tra le 12 presenti (combinazioni di 12 elementi a 2 a 2) e 3 non-figure tra le 28 carte rimanenti (combinazioni di 28 elementi a 3 a 3): \[ \text{Casi favorevoli} = \binom{12}{2} \cdot \binom{28}{3} = 66 \cdot 3276 = 216\,216. \]
Il rapporto ci dà la probabilità desiderata:
Metodo 3 — Ragionamento sequenziale (senza combinatoria)
Immaginiamo di estrarre le 5 carte una dopo l'altra senza reimmissione. Calcoliamo la probabilità di ottenere una sequenza specifica, per esempio (Figura, Figura, Non-Figura, Non-Figura, Non-Figura):
- 1ª carta Figura: \(\frac{12}{40}\)
- 2ª carta Figura: \(\frac{11}{39}\)
- 3ª carta Non-Figura: \(\frac{28}{38}\)
- 4ª carta Non-Figura: \(\frac{27}{37}\)
- 5ª carta Non-Figura: \(\frac{26}{36}\)
La probabilità di questa singola sequenza è:
Le 2 figure e le 3 non-figure possono però presentarsi in diversi ordini. Il numero di sequenze possibili corrisponde al numero di modi in cui possiamo posizionare le 2 figure nei 5 posti disponibili, cioè \(\binom{5}{2} = 10\) ordini diversi (es. F-F-NF-NF-NF, F-NF-F-NF-NF, ecc.).
Moltiplicando per 10 otteniamo la probabilità totale:
Esempio applicativo — Controllo qualità su un lotto finito
Un lotto di 50 pezzi contiene 4 pezzi difettosi. Si preleva un campione di 10 pezzi per il controllo (senza reimmissione). Qual è la probabilità che il campione contenga almeno un pezzo difettoso?
In tutti i metodi conviene passare all'evento complementare: calcoliamo la probabilità di non trovare nessun pezzo difettoso nel campione (\(X=0\)) e sottraiamo il risultato da 1.
Metodo 1 — Con la formula della distribuzione ipergeometrica
Poniamo \(N=50\), \(K=4\) (difettosi), \(n=10\), \(k=0\):
Metodo 2 — Casi favorevoli / Casi possibili (definizione classica)
Per calcolare la probabilità dell'evento complementare (prendere 10 pezzi tutti sani):
- Casi possibili: i modi di scegliere 10 pezzi qualsiasi sui 50 totali: \[ \text{Casi possibili} = \binom{50}{10}. \]
- Casi favorevoli: i modi di scegliere 10 pezzi tutti sani dai 46 non difettosi: \[ \text{Casi favorevoli} = \binom{46}{10}. \]
La probabilità di non trovare difettosi è:
Quindi la probabilità di trovarne almeno uno è:
Metodo 3 — Ragionamento sequenziale (senza combinatoria)
Calcoliamo la probabilità di estrarre 10 pezzi tutti non difettosi uno di seguito all'altro:
- 1° pezzo non difettoso: \(\frac{46}{50}\)
- 2° pezzo non difettoso: \(\frac{45}{49}\)
- ... e così via fino al 10° pezzo: \(\frac{37}{41}\)
Moltiplicando le probabilità delle 10 estrazioni successive otteniamo:
Semplificando i termini incrociati dal 46 al 41 tra numeratore e denominatore, il calcolo si riduce a:
Passando infine al complementare:
Considerazione: anche con solo l'8% del lotto difettoso (4 su 50), un campione di soli 10 pezzi ha oltre il 60% di probabilità di intercettare almeno un pezzo difettoso.
Valore atteso dalla definizione generale
Un'urna contiene 8 palline, di cui 3 rosse e 5 blu. Si estraggono simultaneamente 2 palline. Calcola il valore atteso del numero di palline rosse estratte, utilizzando la definizione generale di valore atteso vista nella Sezione 1.
Qui \(N=8\), \(K=3\) (rosse) e \(n=2\). La variabile aleatoria \(X\) (numero di palline rosse) può assumere i valori 0, 1 o 2.
Calcolo esplicito delle probabilità
I casi possibili totali per scegliere 2 palline su 8 sono \(\binom{8}{2} = \frac{8 \cdot 7}{2} = 28\).
- Nessuna rossa (\(X=0\)): scegliamo 0 rosse su 3 e 2 blu su 5 (oppure, sequenzialmente, \(\frac{5}{8} \cdot \frac{4}{7}\)):
\[ P(X=0) = \frac{\binom{3}{0} \cdot \binom{5}{2}}{\binom{8}{2}} = \frac{1 \cdot 10}{28} = \frac{10}{28} = \frac{5}{14}. \]
- 1 rossa e 1 blu (\(X=1\)): scegliamo 1 rossa su 3 e 1 blu su 5, ricordando i 2 ordini possibili (R-B o B-R):
\[ P(X=1) = \frac{\binom{3}{1} \cdot \binom{5}{1}}{\binom{8}{2}} = \frac{3 \cdot 5}{28} = \frac{15}{28}. \]
- 2 rosse (\(X=2\)): scegliamo 2 rosse su 3 e 0 blu su 5 (oppure, sequenzialmente, \(\frac{3}{8} \cdot \frac{2}{7}\)):
\[ P(X=2) = \frac{\binom{3}{2} \cdot \binom{5}{0}}{\binom{8}{2}} = \frac{3 \cdot 1}{28} = \frac{3}{28}. \]
Raccogliamo i valori calcolati nella tabella di distribuzione di probabilità:
| \(x_i\) | 0 | 1 | 2 |
|---|---|---|---|
| \(P_X(x_i)\) | \(\frac{5}{14}\) \(\left(\frac{10}{28}\right)\) | \(\frac{15}{28}\) | \(\frac{3}{28}\) |
Applichiamo la definizione generale di valore atteso (\(E[X] = \sum x_i \cdot P_X(x_i)\)):
Si osservi che questo risultato coincide esattamente con \(n \cdot \frac{K}{N} = 2 \cdot \frac{3}{8} = \frac{3}{4} = 0.75\) — cioè con il numero di estrazioni moltiplicato per la proporzione di elementi favorevoli nell'urna. È la stessa intuizione della distribuzione binomiale (\(E[X] = np\)).
Una tabella riassuntiva con formula, parametri, valore atteso e varianza di tutte le distribuzioni viste in questa pagina, utile come ripasso rapido prima di una verifica.
| Distribuzione | \(P_X(k)\) | Parametri | \(E[X]\) | \(\text{Var}(X)\) |
|---|---|---|---|---|
| Uniforme discreta (su \(1,2,\dots,n\)) |
\(\dfrac{1}{n}\) | \(n\) | \(\dfrac{n+1}{2}\) | \(\dfrac{n^2-1}{12}\) |
| Binomiale | \(\dbinom{n}{k} p^k (1-p)^{n-k}\) | \(n\), \(p\) | \(np\) | \(np(1-p)\) |
| Poisson | \(\dfrac{\lambda^k}{k!} e^{-\lambda}\) | \(\lambda\) | \(\lambda\) | \(\lambda\) |
| Geometrica | \((1-p)^{k-1} p\) | \(p\) | \(\dfrac{1}{p}\) | \(\dfrac{1-p}{p^2}\) |
| Ipergeometrica | \(\dfrac{\binom{K}{k}\binom{N-K}{n-k}}{\binom{N}{n}}\) | \(N\), \(K\), \(n\) | \(n \cdot \dfrac{K}{N}\) | \(n \cdot \dfrac{K}{N} \cdot \left(1-\dfrac{K}{N}\right) \cdot \dfrac{N-n}{N-1}\) |
Nota: per l'uniforme discreta e per l'ipergeometrica, le formule di \(E[X]\) e \(\text{Var}(X)\) sono riportate qui per completezza, ma non ne abbiamo dimostrato la derivazione nelle rispettive sezioni.