 www.matefilia.it
 dal 2001
home > unità didattiche > calcolo delle probabilità DSA
CALCOLO DELLE PROBABILITÀ
(Versione DSA)
Dalla probabilità classica al teorema di Bayes
Prima di affrontare le distribuzioni di probabilità discrete (binomiale, Poisson, geometrica, ipergeometrica), richiamiamo i concetti fondamentali di calcolo delle probabilità: probabilità classica, probabilità totale, probabilità composta, probabilità condizionata e il teorema di Bayes.
💡 Per una visualizzazione ottimale dei grafici e delle formule, se stai usando lo smartphone disponilo orizzontalmente.
Clicca su ciascuna sezione per aprirla o chiuderla. Puoi tenere aperte più sezioni contemporaneamente.
Una variabile aleatoria discreta \(X\) è una grandezza che, a seguito di un esperimento casuale (aleatorio), può assumere un numero finito di valori \(x_1, x_2, \dots, x_n\), ciascuno con una determinata probabilità \(p_1, p_2, \dots, p_n\), tali che
Studiare una distribuzione di probabilità significa, in pratica, saper rispondere a domande come: quali valori può assumere \(X\)? Con che probabilità assume ciascun valore? Qual è il valore "medio" che ci aspettiamo osservando l'esperimento molte volte (il valore atteso)? Quanto i valori osservati tendono ad allontanarsi da questa media (la varianza)? Per rispondere a queste domande in modo rigoroso — e non solo per intuito — abbiamo bisogno di alcuni strumenti di base del calcolo delle probabilità: la probabilità classica, la probabilità totale, la probabilità composta e la probabilità condizionata, che richiamiamo nelle sezioni seguenti.
Esperimento aleatorio, spazio campionario, evento
Un esperimento aleatorio è un esperimento il cui risultato non è prevedibile con certezza, nemmeno ripetendolo più volte nelle stesse condizioni (ad esempio: il lancio di un dado, il lancio di una moneta, l'estrazione di una carta da un mazzo).
L'insieme di tutti i possibili risultati (o esiti elementari) di un esperimento aleatorio si chiama spazio campionario e si indica con \(\Omega\). Ad esempio, nel lancio di un dado a sei facce lo spazio campionario è \(\Omega = \{1, 2, 3, 4, 5, 6\}\).
Un evento \(E\) è un sottoinsieme dello spazio campionario, \(E \subseteq \Omega\). Si dice che l'evento \(E\) si verifica quando il risultato dell'esperimento è uno degli esiti che appartengono a \(E\). Ad esempio, nel lancio di un dado l'evento "esce un numero pari" è \(E = \{2, 4, 6\}\).
Due casi particolari: l'evento certo coincide con l'intero spazio campionario (\(E = \Omega\)) e si verifica sempre; l'evento impossibile è l'insieme vuoto (\(E = \emptyset\)) e non si verifica mai.
Esempio — Evento certo
Lanciando un dado a sei facce, l'evento \(E\) = "esce un numero minore di 7" è l'evento certo, perché \(E = \{1, 2, 3, 4, 5, 6\} = \Omega\): si verifica sempre, qualunque sia il risultato del lancio.
Esempio — Evento impossibile
Lanciando un dado a sei facce, l'evento \(E\) = "esce il numero 7" è l'evento impossibile, perché nessun esito dello spazio campionario \(\Omega = \{1, 2, 3, 4, 5, 6\}\) appartiene a \(E\): non si può mai verificare.
Definizione classica (di Laplace)
Se lo spazio campionario \(\Omega\) è costituito da un numero finito di casi ugualmente possibili, la probabilità di un evento \(E\) è
Poiché il numero dei casi favorevoli non può mai essere negativo (al minimo è 0, quando l'evento è impossibile) né può mai superare il numero dei casi possibili (al massimo i casi favorevoli coincidono con tutti i casi possibili, quando l'evento è certo), la probabilità di un evento è sempre compresa tra 0 e 1, estremi inclusi:
La probabilità può essere espressa in tre modi equivalenti: come frazione (casi favorevoli / casi possibili), come numero decimale compreso tra 0 e 1 (estremi inclusi), oppure come percentuale compresa tra 0% (evento impossibile) e 100% (evento certo).
Esempi semplici
Esempio 1 — Il lancio di una moneta
Si lanciano due monete equilibrate. Lo spazio campionario è \(\Omega = \{TT, TC, CT, CC\}\), con 4 casi ugualmente possibili. Qual è la probabilità dell'evento \(E\) = "esce almeno una testa"?
I casi favorevoli sono \(TT, TC, CT\), quindi
Esempio 2 — Il lancio di un dado
Si lancia un dado a sei facce non truccato. Qual è la probabilità dell'evento \(E\) = "esce un numero primo"?
Lo spazio campionario è \(\Omega = \{1, 2, 3, 4, 5, 6\}\) (6 casi possibili), mentre i numeri primi tra 1 e 6 sono 2, 3, 5 (3 casi favorevoli). Quindi
Esempio 3 — Estrazione da un'urna
Un'urna contiene 5 palline rosse e 3 palline blu, indistinguibili al tatto. Si estrae una pallina a caso. Qual è la probabilità che sia rossa?
I casi possibili sono \(5 + 3 = 8\), i casi favorevoli sono 5 (le palline rosse), quindi
Esempio 4 — Il gioco del lotto
Il Lotto è un gioco a estrazione basato su 10 ruote (una per ogni città sede storica di estrazione: Bari, Cagliari, Firenze, Genova, Milano, Napoli, Palermo, Roma, Torino, Venezia, più la ruota Nazionale). Su ciascuna ruota vengono estratti a caso, senza reimmissione, 5 numeri tra 1 e 90.
Su una ruota del lotto vengono estratti a caso numeri da 1 a 90. Qual è la probabilità che il primo numero estratto sia pari?
I casi possibili sono 90, i numeri pari da 1 a 90 sono 45 (i casi favorevoli), quindi
Esempio 5 — Lancio di due dadi: la somma dei punteggi
Si lanciano due dadi a sei facce. Qual è la probabilità che la somma dei due punteggi sia 7?
Lo spazio campionario ha \(6 \times 6 = 36\) coppie ordinate ugualmente possibili (ad esempio \((3,4)\) e \((4,3)\) sono due esiti distinti). Le coppie che danno somma 7 sono
cioè 6 casi favorevoli. Quindi
È la somma più probabile: ad esempio la somma 2 (solo \((1,1)\)) ha probabilità \(\frac{1}{36}\), molto più piccola.
Esempio 6 — Estrazione di una figura
Da un mazzo di 40 carte (4 semi da 10 carte ciascuno, di cui 3 figure per seme: Fante, Cavallo, Re) si estrae una carta a caso. Qual è la probabilità che sia una figura?
I casi possibili sono 40, le figure sono \(3 \times 4 = 12\) (i casi favorevoli), quindi
Esempi con il calcolo combinatorio
Quando i casi possibili non si contano più a uno a uno, ma per gruppi (sottoinsiemi, allineamenti), il calcolo combinatorio (disposizioni, permutazioni, combinazioni) diventa lo strumento indispensabile per applicare la definizione classica.
Esempio 7 — Estrazione di carte
Da un mazzo di 40 carte (4 semi, 10 valori, di cui 4 Re) si estraggono contemporaneamente 4 carte. Qual è la probabilità di ottenere esattamente 2 Re?
I casi possibili sono le combinazioni di 4 carte scelte tra 40:
I casi favorevoli si ottengono scegliendo 2 Re tra i 4 disponibili e le altre 2 carte tra le 36 rimanenti (non Re):
Quindi
Esempio 8 — Il lotto: probabilità di un ambo
Su una ruota vengono estratti simultaneamente 5 numeri tra i 90. Qual è la probabilità che, tra i 5 numeri estratti, compaiano entrambi due numeri fissati in anticipo (ad esempio 7 e 23)?
I casi possibili sono tutte le cinquine estraibili:
I casi favorevoli si ottengono fissando i 2 numeri scelti e completando la cinquina con 3 numeri qualsiasi tra i restanti 88:
Quindi
Esempio 9 — Urna con estrazione simultanea
Un'urna contiene 6 palline rosse e 4 palline verdi. Si estraggono simultaneamente 3 palline. Qual è la probabilità di ottenere esattamente 2 palline rosse e 1 verde?
I casi possibili sono le combinazioni di 3 palline scelte tra le 10:
I casi favorevoli si ottengono scegliendo 2 rosse tra 6 e 1 verde tra 4:
Quindi
Esempio 10 — Anagrammi di una parola
Quando si vogliono contare gli anagrammi di una parola con lettere ripetute, si usa la formula delle permutazioni con ripetizione: se un insieme di \(n\) elementi contiene un elemento ripetuto \(k_1\) volte, un altro ripetuto \(k_2\) volte, e così via, il numero di allineamenti distinti è
Si scrive a caso un anagramma della parola ESAME (5 lettere: E, S, A, M, E, con la lettera E ripetuta due volte). Qual è la probabilità che le due lettere E si trovino in posizioni adiacenti?
Il numero totale di anagrammi (casi possibili), applicando la formula con \(n = 5\) e la lettera E ripetuta \(k_1 = 2\) volte, è
I casi favorevoli si contano trattando le due E come un unico blocco: si dispongono così 4 elementi (il blocco EE, S, A, M), quindi
Quindi
Esempio 11 — Formazione di una delegazione
In una classe di 20 studenti (12 ragazze e 8 ragazzi) si sceglie a caso una delegazione di 3 studenti. Qual è la probabilità che sia composta da 2 ragazze e 1 ragazzo?
I casi possibili sono le combinazioni di 3 studenti scelti tra 20:
I casi favorevoli si ottengono scegliendo 2 ragazze tra 12 e 1 ragazzo tra 8:
Quindi
Esempio 12 — Poker: probabilità di una coppia
Da un mazzo di 40 carte (10 valori, 4 semi) si estraggono contemporaneamente 5 carte. Qual è la probabilità di ottenere esattamente una coppia, cioè due carte dello stesso valore e le altre tre di valori diversi tra loro e diversi da quello della coppia?
Casi possibili. Sono tutti i modi di scegliere 5 carte tra le 40 del mazzo, senza tener conto dell'ordine:
Casi favorevoli. Costruiamo una mano con "una coppia" scegliendo, in ordine, quattro cose indipendenti:
1) Il valore della coppia: 10 scelte possibili (uno dei 10 valori delle carte).
2) I 2 semi della coppia: tra i 4 semi disponibili per quel valore, dobbiamo sceglierne 2:
3) I 3 valori diversi delle altre carte: vanno scelti tra i 9 valori rimasti (diversi da quello della coppia), e devono essere diversi tra loro (altrimenti si formerebbe un'altra coppia, un tris, ecc.):
4) Il seme di ciascuna di queste 3 carte: per ognuna dei 3 valori scelti al punto precedente c'è una scelta libera tra 4 semi, quindi
Per il principio di moltiplicazione, il numero totale di mani favorevoli è il prodotto di queste quattro scelte indipendenti:
Probabilità. Dividendo i casi favorevoli per i casi possibili:
È una probabilità piuttosto alta: quasi una mano su due, estraendo 5 carte a caso, ha esattamente una coppia.
Probabilità geometrica
La definizione classica richiede che i casi possibili siano in numero finito. Ma cosa succede quando lo spazio campionario è "continuo" — ad esempio un punto scelto a caso su un segmento, in una regione del piano, o all'interno di un solido — e i casi possibili sono quindi infiniti? In questa situazione non ha più senso "contare" i casi, ma possiamo comunque ragionare per analogia, sostituendo il conteggio con una misura geometrica (lunghezza, area o volume, a seconda del contesto):
Questa è la probabilità geometrica: l'idea di fondo è la stessa della probabilità classica (un rapporto tra "quanto favorevole" e "quanto possibile"), applicata a grandezze continue invece che a un numero finito di casi.
Esempio 1 — Punto scelto su un segmento (facile)
Un punto \(P\) viene scelto a caso sul segmento \([0, 10]\). Qual è la probabilità che \(P\) cada nell'intervallo \([3, 7]\)?
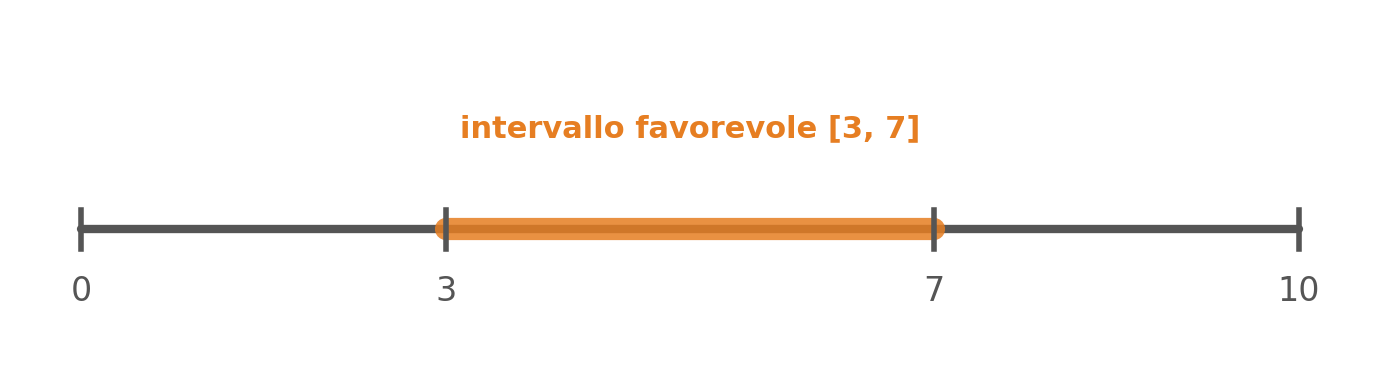
La misura da usare è la lunghezza. Il segmento totale ha lunghezza \(10 - 0 = 10\), l'intervallo favorevole ha lunghezza \(7 - 3 = 4\). Quindi
Esempio 2 — Il bersaglio
Un bersaglio circolare ha raggio \(R = 6\) e al centro una zona circolare di raggio \(r = 2\). Un dardo colpisce il bersaglio in un punto scelto a caso (supponendo che il bersaglio venga colpito sempre, in un punto qualsiasi con la stessa "densità"). Qual è la probabilità che colpisca la zona centrale?
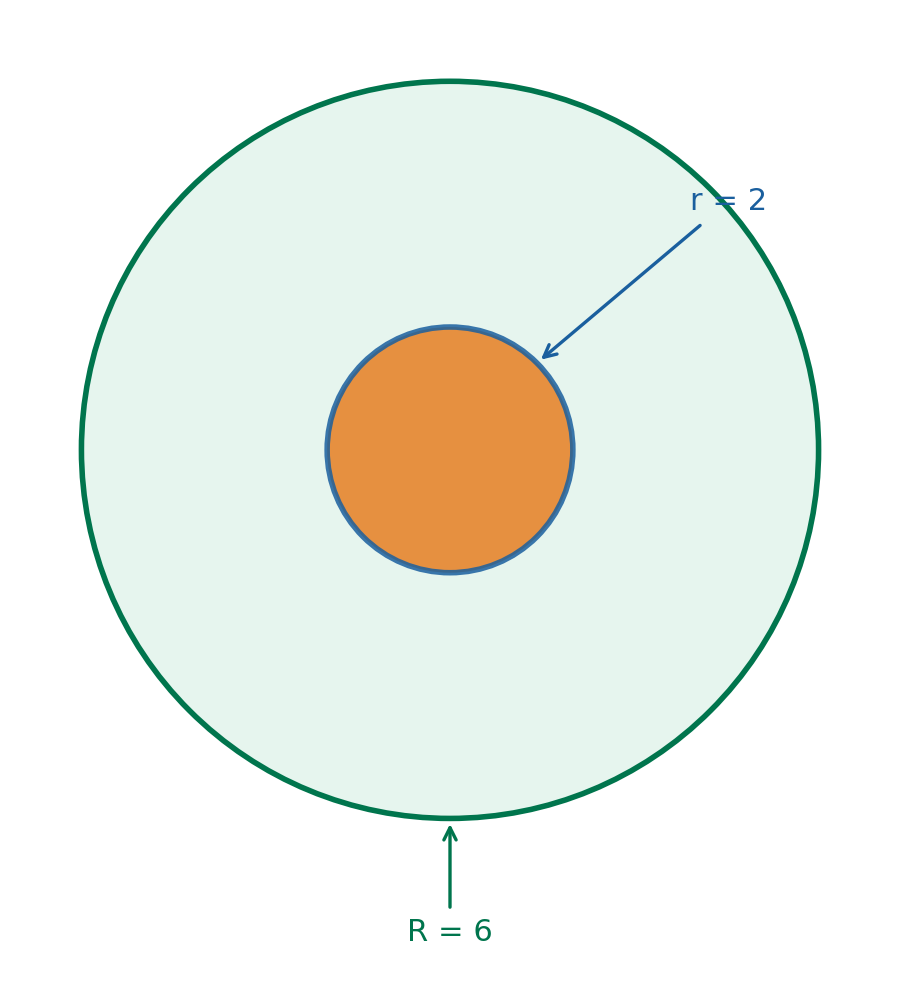
Qui la misura da usare è l'area. L'area del bersaglio è \(\pi R^2\), l'area della zona centrale è \(\pi r^2\). Nel rapporto, \(\pi\) si semplifica:
Esempio 3 — Sfera circoscritta a un cubo
Un cubo di lato \(a\) è inscritto in una sfera (cioè la sfera passa per tutti gli 8 vertici del cubo — si dice che la sfera è circoscritta al cubo). Un punto viene scelto a caso all'interno della sfera. Qual è la probabilità che cada anche all'interno del cubo?
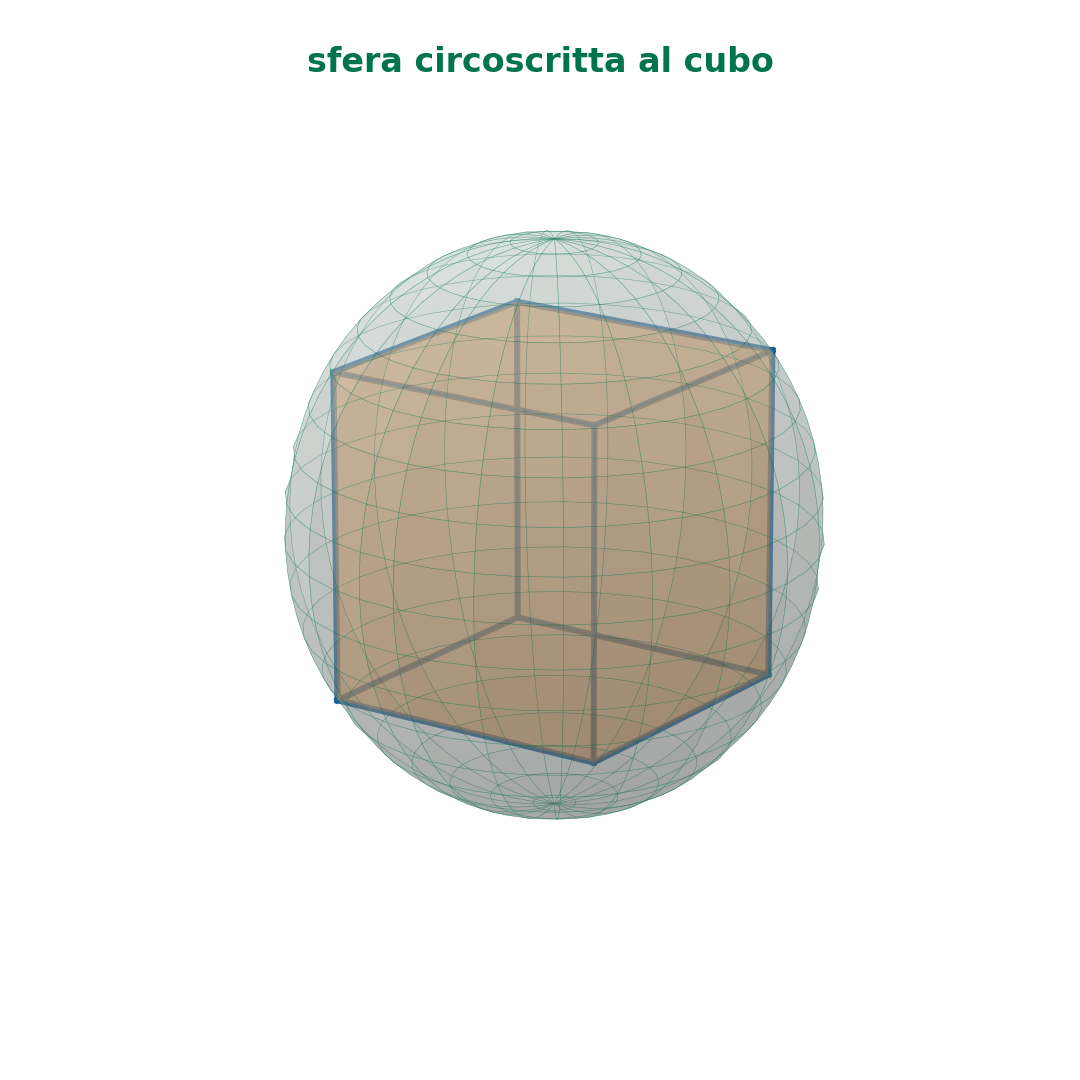
Qui la misura da usare è il volume. Il volume del cubo è \(a^3\). Per il volume della sfera serve il suo raggio \(R\): la diagonale del cubo (che è anche il diametro della sfera, poiché unisce due vertici opposti passando per il centro) misura \(a\sqrt{3}\), quindi \(R = \dfrac{a\sqrt{3}}{2}\). Il volume della sfera è allora
La probabilità cercata è il rapporto tra i due volumi (il fattore \(a^3\) si semplifica):
Esempio 4 — Il problema dell'incontro (più elaborato)
Due amici, A e B, si danno appuntamento tra le 12:00 e le 13:00. Ciascuno arriva in un istante scelto a caso in quell'ora, indipendentemente dall'altro, e aspetta al massimo 15 minuti prima di andarsene se l'altro non si è ancora presentato. Qual è la probabilità che i due amici si incontrino?
Indichiamo con \(x\) e \(y\) (in minuti, da 0 a 60) gli istanti di arrivo di A e B. Poiché entrambi possono arrivare in un qualunque istante dell'ora, ogni coppia \((x,y)\) è un punto scelto a caso nel quadrato \([0,60] \times [0,60]\): lo spazio campionario è quindi un'area, non più un segmento come nell'Esempio 1.
Ragioniamo su quando i due amici non si incontrano, che è più intuitivo: supponiamo che A arrivi prima di B (cioè \(x < y\)). A aspetta 15 minuti; se B non si è presentato entro quel termine, cioè se \(y > x + 15\), A se ne va prima che B arrivi, e i due si mancano. Simmetricamente, se è B ad arrivare prima (\(y < x\)), i due si mancano se \(x > y + 15\). In entrambi i casi, la condizione per non incontrarsi è che uno dei due arrivi con più di 15 minuti di ritardo rispetto all'altro, cioè \(y - x > 15\) oppure \(x - y > 15\) — che si scrive in modo compatto come \(|x - y| > 15\). Di conseguenza, i due amici si incontrano esattamente quando questa condizione non si verifica, cioè quando la differenza tra i loro istanti di arrivo è al più 15 minuti:
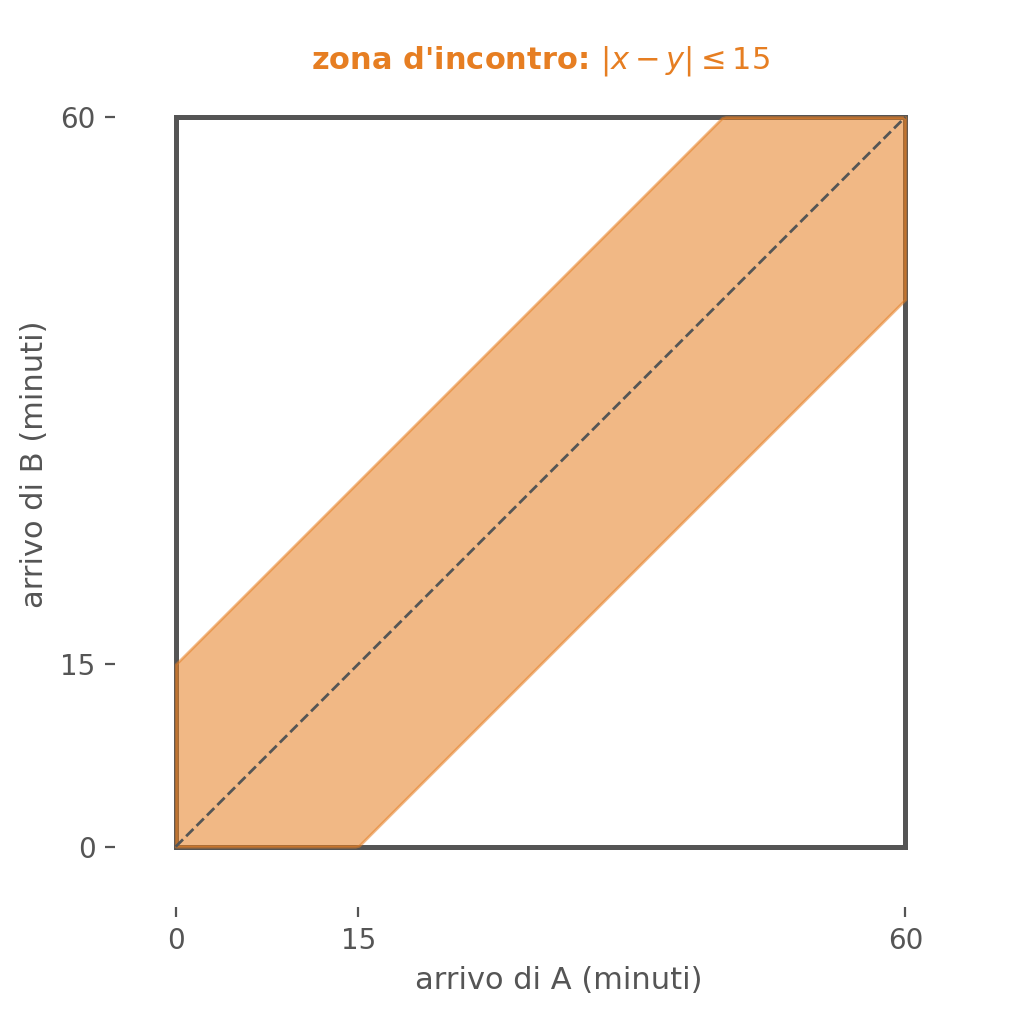
La regione favorevole è la fascia diagonale intorno alla bisettrice \(x = y\) (dove i due arrivi sono vicini nel tempo), quella sfavorevole sono i due triangoli agli angoli opposti, dove la differenza tra gli arrivi supera i 15 minuti. Ciascun triangolo ha cateti lunghi \(60 - 15 = 45\), quindi area \(\frac{45^2}{2}\). L'area totale del quadrato è \(60^2 = 3600\). La probabilità di non incontrarsi è la somma delle aree dei due triangoli divisa per l'area totale:
Quindi, per l'evento complementare:
Nonostante ciascuno aspetti solo un quarto d'ora su un'ora intera di possibile arrivo, la probabilità di incontrarsi è comunque piuttosto alta (quasi il 44%): un risultato non scontato, che mostra bene la potenza del ragionamento geometrico applicato alla probabilità.
Approfondimento — Il metodo Monte Carlo (simulazione interattiva)
C'è un modo sorprendente di usare la probabilità geometrica "al contrario": invece di calcolare una probabilità nota a priori, possiamo stimarla lanciando punti a caso e osservando le frequenze — esattamente come nella probabilità frequentista che vedremo tra poco. Questa tecnica si chiama metodo Monte Carlo (dal nome della celebre città del gioco d'azzardo, per l'analogia con il lancio di dadi e palline della roulette).
Consideriamo un quadrato di lato 2 (da \(-1\) a \(1\) su entrambi gli assi) con inscritto un cerchio di raggio 1. Come nell'Esempio 2 (il bersaglio), la probabilità che un punto scelto a caso nel quadrato cada anche nel cerchio è il rapporto delle aree:
Se generiamo tanti punti a caso nel quadrato e contiamo la frazione che cade nel cerchio, questa frazione si avvicinerà sempre di più a \(\frac{\pi}{4}\) (proprio come le frequenze si stabilizzavano negli esempi della moneta e del tiratore): possiamo quindi stimare \(\pi\) come 4 volte quella frazione! Prova tu stesso qui sotto: premi il bottone per lanciare dei punti a caso e osserva la stima convergere.
Punti totali: 0
Punti nel cerchio: 0
Stima di \(\pi\): —
Errore rispetto a \(\pi\) reale: —
Probabilità frequentista
La probabilità classica (ed anche quella geometrica) richiedono di conoscere in anticipo tutti i casi possibili e di poterli considerare equamente probabili. Ma cosa facciamo se questa condizione non è garantita — ad esempio con una moneta di cui non sappiamo se è equilibrata, o un dado truccato? In questi casi non possiamo ricorrere al conteggio dei casi, ma possiamo comunque stimare la probabilità osservando l'esperimento ripetuto molte volte.
La probabilità frequentista di un evento \(E\) è definita come il valore a cui si avvicina, sempre di più, la frequenza relativa con cui \(E\) si verifica, ripetendo l'esperimento un numero \(n\) di volte sempre più grande:
A differenza della classica, qui la probabilità non si calcola a priori con un ragionamento teorico, ma si stima a posteriori dai dati sperimentali.
Osservazione: la Legge dei grandi numeri
La definizione di probabilità frequentista si basa su un risultato fondamentale del calcolo delle probabilità: la Legge dei grandi numeri. Questo teorema garantisce che, per \(n\) sufficientemente grande, la frequenza relativa di un evento \(E\) si stabilizza, avvicinandosi sempre di più alla sua probabilità "vera" \(P(E)\): il comportamento imprevedibile delle singole prove tende a "compensarsi" su un numero grande di ripetizioni, rendendo la frequenza relativa uno stimatore via via più affidabile di \(P(E)\) al crescere di \(n\).
È importante non confondere questo risultato con la cosiddetta fallacia dello scommettitore (o fallacia del giocatore): la Legge dei grandi numeri non dice che un evento debba verificarsi più spesso in futuro per "compensare" una serie di risultati sfavorevoli nel passato — ad esempio, dopo diverse teste consecutive nel lancio di una moneta equilibrata, la probabilità che esca ancora testa al lancio successivo resta sempre \(1/2\), non diminuisce. La legge afferma invece che, aumentando il numero di prove, l'effetto di eventuali sequenze iniziali "anomale" diventa via via trascurabile rispetto al totale.
Approfondimento — Simulazione: il lancio della moneta
Possiamo osservare la Legge dei grandi numeri "in diretta" con l'esperimento più semplice possibile: il lancio di una moneta equilibrata. Ad ogni lancio la probabilità di ottenere testa è \(1/2\), ma la frequenza relativa osservata dopo pochi lanci può discostarsi parecchio da questo valore — per poi stabilizzarsi sempre di più man mano che il numero di lanci cresce.
Il grafico qui sotto mostra, lancio dopo lancio, come varia la frequenza relativa di "testa": prova tu stesso a lanciare la moneta molte volte e osserva la linea avvicinarsi sempre di più alla retta tratteggiata a \(0{,}5\).
Lanci totali: 0
Teste ottenute: 0
Frequenza relativa: —
Scarto da \(0{,}5\): —
Esempio — Una moneta "sospetta"
Si sospetta che una moneta non sia equilibrata, cioè che non dia testa e croce con la stessa probabilità. Non potendo applicare la definizione classica (non sappiamo se i due esiti sono equamente probabili), la si lancia un numero crescente di volte, contando la frequenza relativa di "testa":
| Numero di lanci | 10 | 100 | 1.000 | 10.000 | 100.000 |
|---|---|---|---|---|---|
| Frequenza di "testa" | 0.600 | 0.610 | 0.580 | 0.596 | 0.599 |
Con pochi lanci la frequenza oscilla parecchio (con 10 lanci potrebbe uscire anche molto lontana dal valore reale, per puro caso), ma aumentando il numero di lanci si stabilizza sempre di più intorno a un valore, in questo caso circa \(0.6\). Possiamo quindi stimare \(P(\text{testa}) \approx 0.6 = 60\%\): la moneta è realmente sbilanciata verso testa.
Esempio — La percentuale di un tiratore di canestri
Un giocatore di basket si allena ai tiri liberi. Non conosciamo a priori la sua reale probabilità di segnare (dipende dalla sua abilità, non è calcolabile con la definizione classica), ma possiamo stimarla osservando i risultati di un numero crescente di tiri:
| Numero di tiri | 10 | 50 | 200 | 1.000 | 5.000 |
|---|---|---|---|---|---|
| Frequenza di canestro | 1.000 | 0.860 | 0.760 | 0.756 | 0.748 |
Con soli 10 tiri il giocatore li ha segnati tutti (frequenza \(1\)): un campione così piccolo può dare un'idea molto distorta della sua reale abilità, per puro caso. Già con 200 tiri, però, la frequenza si è avvicinata parecchio al valore a cui tende, circa \(0.75\), e con 1.000 e 5.000 tiri resta stabile intorno a quel valore. Possiamo quindi stimare \(P(\text{canestro}) \approx 0.75 = 75\%\): un buon tiratore, ma non infallibile come sembrava dopo i primi 10 tiri.
Poiché un evento è un sottoinsieme dello spazio campionario, tra eventi si possono eseguire le stesse operazioni che si eseguono tra insiemi: unione, intersezione, complementazione. Il risultato di ciascuna operazione è ancora un evento.
Evento unione
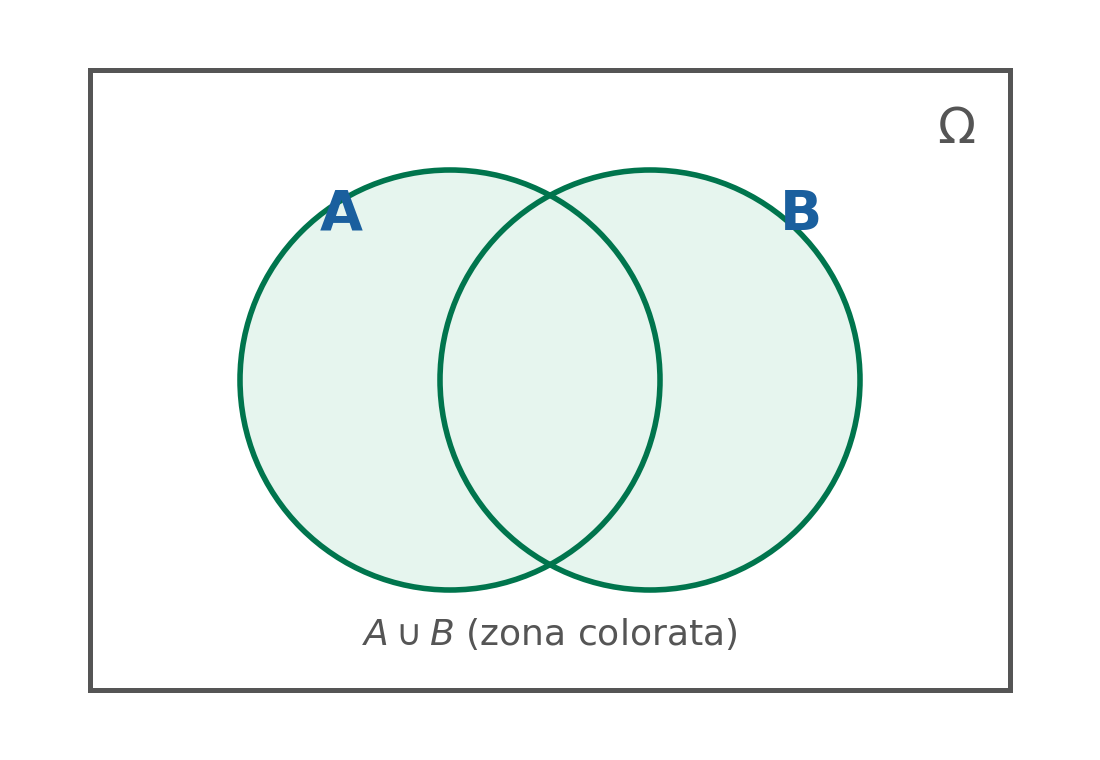
Dati due eventi \(A\) e \(B\), l'evento unione \(A \cup B\) è l'evento che si verifica quando si verifica \(A\), oppure si verifica \(B\), oppure si verificano entrambi.
Esempio — Evento unione
Lanciando un dado, siano \(A\) = "esce un numero pari" \(= \{2, 4, 6\}\) e \(B\) = "esce un numero maggiore di 4" \(= \{5, 6\}\). Allora
Evento intersezione
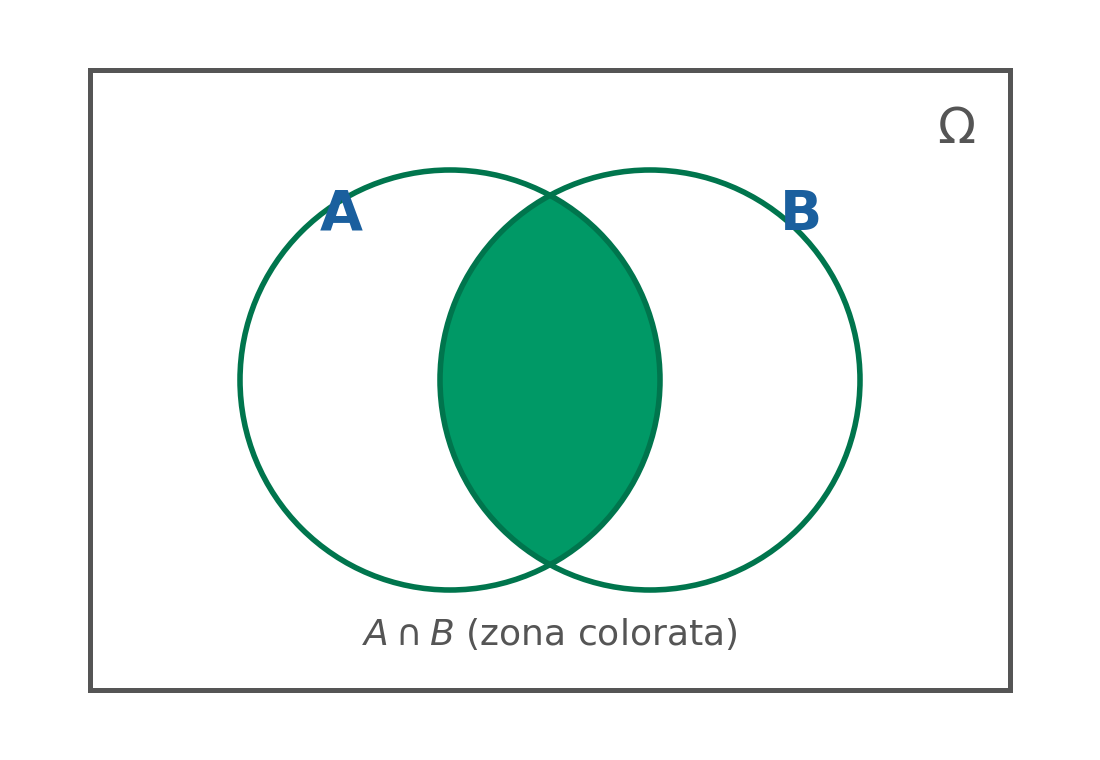
L'evento intersezione \(A \cap B\) è l'evento che si verifica quando si verificano contemporaneamente sia \(A\) sia \(B\).
Esempio — Evento intersezione
Con gli stessi eventi dell'esempio precedente (\(A = \{2, 4, 6\}\), \(B = \{5, 6\}\)):
Infatti 6 è l'unico numero sia pari sia maggiore di 4.
Evento complementare (o contrario)
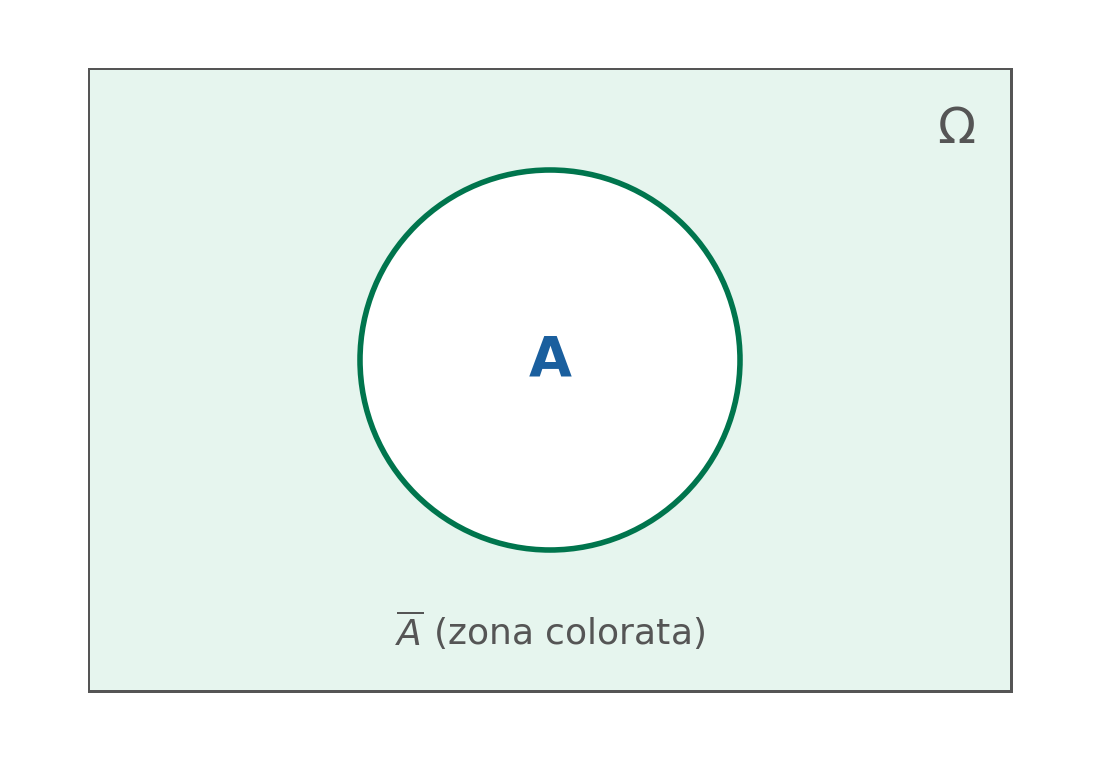
L'evento complementare di \(A\), indicato con \(\overline{A}\) (o \(A^c\)), è l'evento che si verifica esattamente quando non si verifica \(A\). È costituito da tutti gli esiti di \(\Omega\) che non appartengono ad \(A\).
Poiché \(A\) e \(\overline{A}\) insieme esauriscono tutto lo spazio campionario, senza sovrapporsi, vale sempre
Esempio — Evento complementare
Lanciando un dado, se \(A\) = "esce un numero pari" \(= \{2, 4, 6\}\), allora
Poiché \(P(A) = \frac{3}{6} = \frac{1}{2}\), anche \(P(\overline{A}) = 1 - \frac{1}{2} = \frac{1}{2}\), coerentemente col fatto che dispari e pari sono ugualmente probabili.
Eventi incompatibili ed eventi compatibili
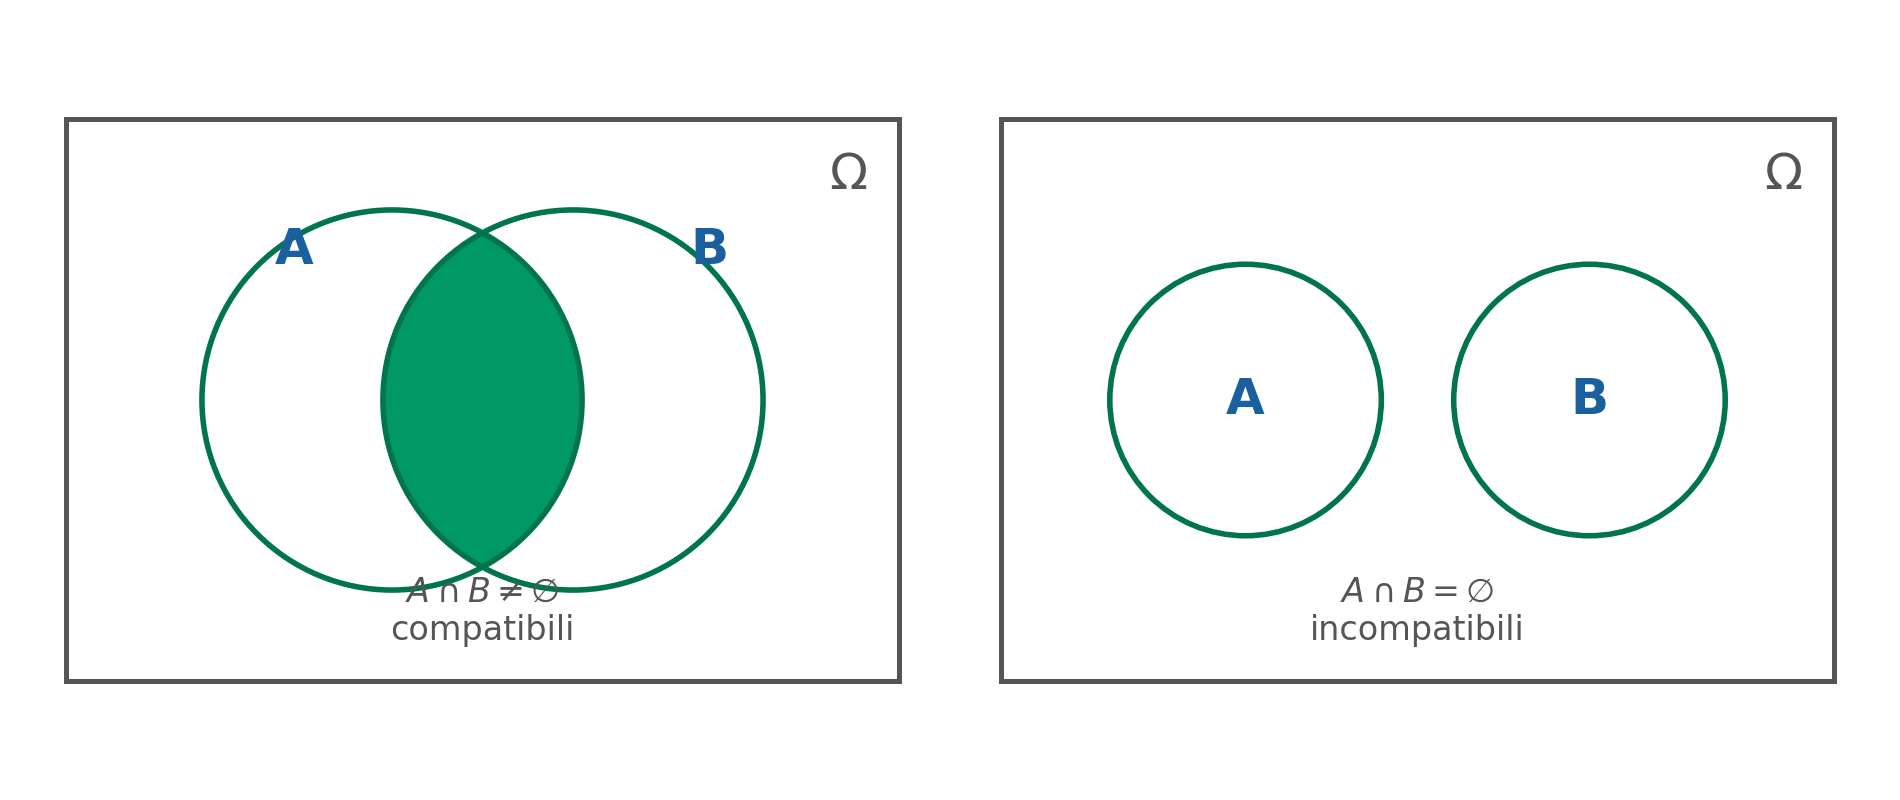
Due eventi \(A\) e \(B\) si dicono incompatibili (o disgiunti) se non possono verificarsi contemporaneamente, cioè se
Se invece \(A\) e \(B\) possono verificarsi contemporaneamente (cioè \(A \cap B \neq \emptyset\)), i due eventi si dicono compatibili.
Esempio — Eventi incompatibili
Lanciando un dado, gli eventi \(A\) = "esce un numero pari" e \(B\) = "esce un numero dispari" sono incompatibili: \(A \cap B = \emptyset\), perché nessun numero è contemporaneamente pari e dispari.
Esempio — Eventi compatibili
Lanciando un dado, gli eventi \(A\) = "esce un numero pari" e \(C\) = "esce un numero minore di 4" sono compatibili: \(A \cap C = \{2\} \neq \emptyset\), perché 2 è sia pari sia minore di 4.
Altri esempi di applicazione
Esempio — Lancio di due dadi: unione e intersezione
Si lanciano due dadi. Sia \(A\) = "la somma dei punteggi è 7" e \(B\) = "esce almeno un 6". Lo spazio campionario ha \(6 \times 6 = 36\) coppie ugualmente possibili.
I casi favorevoli ad \(A\) sono \((1,6),(2,5),(3,4),(4,3),(5,2),(6,1)\): 6 casi. I casi favorevoli a \(B\) sono le coppie con almeno un 6: 11 casi.
\(A\) e \(B\) sono compatibili, perché \(A \cap B = \{(1,6), (6,1)\} \neq \emptyset\): queste due coppie hanno somma 7 e contengono un 6.
Esempio — Carta estratta: evento e suo complementare
Da un mazzo di 40 carte (4 semi da 10 carte, di cui 3 figure per seme) si estrae una carta a caso. Sia \(F\) = "esce una figura". I casi favorevoli a \(F\) sono \(3 \times 4 = 12\), quindi
L'evento complementare \(\overline{F}\) = "esce una carta numerale (non figura)" ha probabilità
Esempio — Delegazione: eventi incompatibili
In una classe di 20 studenti (12 ragazze e 8 ragazzi) si sceglie a caso una delegazione di 3 studenti. Consideriamo gli eventi: \(A_0\) = "nessuna ragazza nella delegazione", \(A_1\) = "esattamente 1 ragazza", \(A_2\) = "esattamente 2 ragazze", \(A_3\) = "3 ragazze".
Questi quattro eventi sono a due a due incompatibili (non si può avere, ad esempio, sia esattamente 1 sia esattamente 2 ragazze nella stessa delegazione), e la loro unione è l'evento certo: uno di essi si verifica sempre, qualunque sia la delegazione scelta. Perciò
Esempio — Poker: eventi compatibili
Da un mazzo di 40 carte si estraggono contemporaneamente 5 carte. Sia \(P_1\) = "c'è almeno un asso" e \(P_2\) = "c'è almeno una coppia (due carte dello stesso valore)". Questi due eventi sono compatibili: \(P_1 \cap P_2 \neq \emptyset\), perché è possibile pescare, ad esempio, una coppia di assi (che appartiene a entrambi gli eventi), oppure un asso singolo insieme a una coppia di un altro valore.
Il teorema della probabilità totale (in questo contesto, relativo all'unione di due eventi) permette di calcolare la probabilità che si verifichi almeno uno tra due eventi \(A\) e \(B\), cioè \(P(A \cup B)\), a partire da \(P(A)\) e \(P(B)\). La formula cambia a seconda che i due eventi possano verificarsi insieme oppure no.
Caso di eventi incompatibili
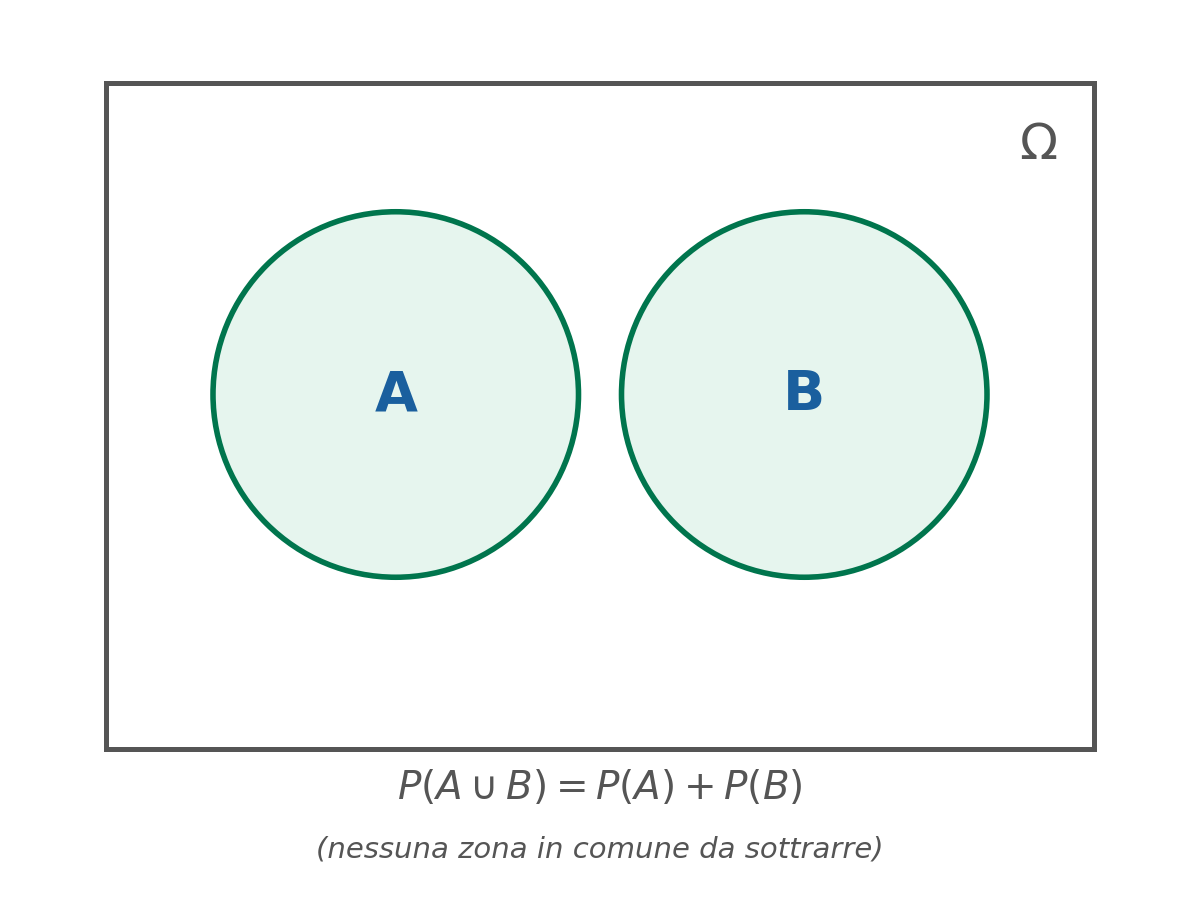
Se \(A\) e \(B\) sono incompatibili (\(A \cap B = \emptyset\), non hanno esiti in comune), i casi favorevoli ad \(A \cup B\) sono semplicemente tutti i casi favorevoli ad \(A\) più tutti i casi favorevoli a \(B\), senza alcuna sovrapposizione da correggere:
Caso generale
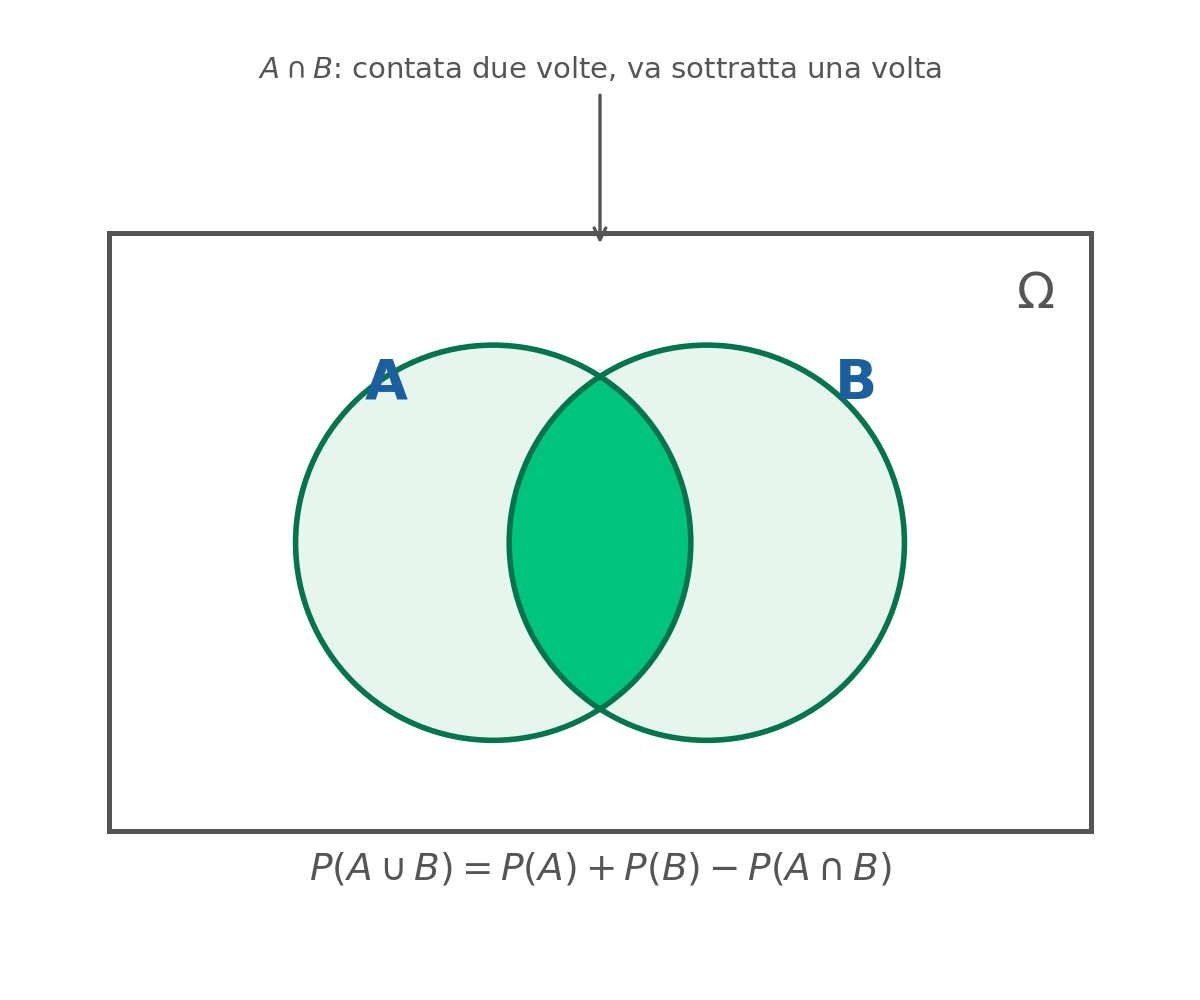
Se invece \(A\) e \(B\) sono compatibili (possono verificarsi insieme), sommando semplicemente \(P(A)\) e \(P(B)\) conteremmo due volte i casi che appartengono sia ad \(A\) sia a \(B\) (cioè quelli di \(A \cap B\)). Per correggere, sottraiamo \(P(A \cap B)\) una volta:
Si noti che questa è la formula generale, valida sempre: nel caso particolare di eventi incompatibili si ha \(P(A \cap B) = 0\), e la formula si riduce a quella vista sopra.
Esempi — eventi incompatibili
Esempio facile
Si lancia un dado a sei facce. Qual è la probabilità che esca 1 oppure 2?
Gli eventi \(A\) = "esce 1" e \(B\) = "esce 2" sono incompatibili (non può uscire contemporaneamente 1 e 2). Quindi
Esempio difficile
Da un mazzo di 40 carte (10 valori, 4 semi) si estraggono contemporaneamente 5 carte. Qual è la probabilità di ottenere un poker di Assi (4 Assi più un'altra carta) oppure un poker di Re (4 Re più un'altra carta)?
I casi possibili sono le combinazioni di 5 carte tra 40:
I casi favorevoli all'evento \(A\) = "poker di Assi" si ottengono prendendo tutti e 4 gli Assi (un solo modo) e una quinta carta qualsiasi tra le restanti 36:
Per simmetria, anche l'evento \(B\) = "poker di Re" ha \(\text{casi}(B) = 36\) e \(P(B) = \dfrac{36}{658\,008}\).
I due eventi sono incompatibili: una mano di 5 carte non può contenere contemporaneamente un poker di Assi e un poker di Re (servirebbero 8 carte). Quindi
Esempi — eventi compatibili
Esempio facile
Si lancia un dado a sei facce. Sia \(A\) = "esce un numero pari" e \(B\) = "esce un numero minore o uguale a 3". Qual è la probabilità che si verifichi \(A\) oppure \(B\)?
\(A = \{2, 4, 6\}\), quindi \(P(A) = \frac{3}{6}\). \(B = \{1, 2, 3\}\), quindi \(P(B) = \frac{3}{6}\). I due eventi sono compatibili: \(A \cap B = \{2\}\), quindi \(P(A \cap B) = \frac{1}{6}\). Applicando la formula generale:
Esempio difficile
Un'urna contiene 10 palline numerate da 1 a 10. Si estraggono simultaneamente 3 palline. Qual è la probabilità che tra le palline estratte ci sia il numero 1 oppure il numero 2 (anche entrambi)?
I casi possibili sono le combinazioni di 3 palline scelte tra 10:
Sia \(A\) = "la pallina 1 è tra le estratte": fissata la pallina 1, le altre 2 si scelgono tra le 9 rimanenti:
Per simmetria, anche \(B\) = "la pallina 2 è tra le estratte" ha \(P(B) = \frac{3}{10}\).
I due eventi sono compatibili: è possibile estrarre sia la pallina 1 sia la pallina 2 nella stessa terna. I casi in cui compaiono entrambe si ottengono fissando le palline 1 e 2, e scegliendo la terza tra le restanti 8:
Applicando la formula generale:
Caso generale con più eventi (partizione)
Tutto quello che abbiamo visto finora riguardava l'unione di due eventi. Ma il "teorema della probabilità totale" ha, nella sua forma completa, un significato più ampio e molto utile: permette di calcolare la probabilità di un evento \(A\) quando questo può verificarsi in diversi scenari alternativi, ciascuno con la propria probabilità.
Più precisamente, supponiamo che gli eventi \(B_1, B_2, \dots, B_n\) formino una partizione dello spazio campionario \(\Omega\): cioè siano a due a due incompatibili (non può verificarsene più di uno alla volta) e la loro unione sia tutto \(\Omega\) (uno di essi si verifica sempre — sono tutti gli scenari possibili, senza eccezioni). La figura seguente mostra proprio questa situazione: lo spazio \(\Omega\) è suddiviso in "fette" \(B_1, B_2, \dots, B_n\) che non si sovrappongono mai e che, tutte insieme, riempiono l'intero \(\Omega\); l'evento \(A\) (l'ellisse) le attraversa, intersecando ciascuna fetta in una zona diversa.
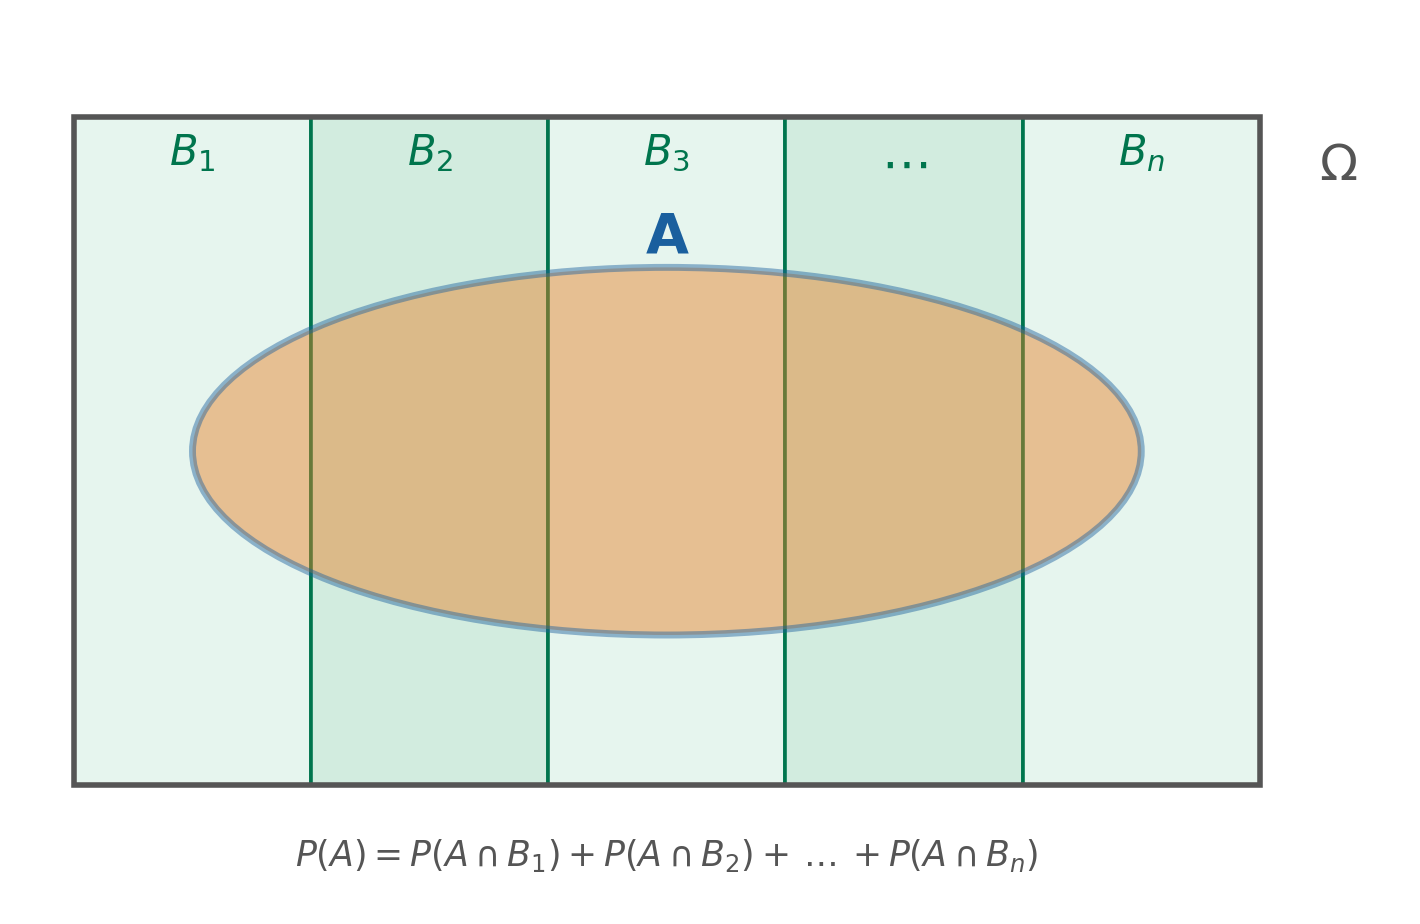
Allora, per un qualsiasi evento \(A\), vale:
L'idea è semplice: per calcolare \(P(A)\), si considera ogni scenario \(B_i\) separatamente (con la sua probabilità \(P(B_i)\)), si calcola quanto sarebbe probabile \(A\) in quello scenario (cioè \(P(A \mid B_i)\)), e infine si sommano tutti i contributi. Uno strumento visivo molto efficace per organizzare questo calcolo è l'albero delle probabilità: si parte con un ramo per ciascuno scenario \(B_i\) (etichettato con \(P(B_i)\)), e da ogni scenario si diramano i possibili esiti di \(A\) (etichettati con le probabilità condizionate \(P(A \mid B_i)\)); moltiplicando le probabilità lungo ogni percorso si ottengono i singoli contributi, che poi si sommano.
Esempio — Estrazione da tre urne
Ci sono tre urne: l'urna A contiene 3 palline rosse e 2 blu, l'urna B contiene 1 pallina rossa e 4 blu, l'urna C contiene 4 palline rosse e 1 blu. Si sceglie a caso una delle tre urne (con la stessa probabilità) e, da questa, si estrae una pallina. Qual è la probabilità che la pallina estratta sia rossa?
Le tre urne formano una partizione: la scelta ricade sempre su una sola di esse (\(A\), \(B\), \(C\) sono incompatibili) e sicuramente su una qualcuna delle tre (la loro unione è l'evento certo). Ciascuna viene scelta con probabilità \(\frac{1}{3}\), e le probabilità di estrarre una pallina rossa nei tre casi sono rispettivamente \(\frac{3}{5}\), \(\frac{1}{5}\) e \(\frac{4}{5}\).
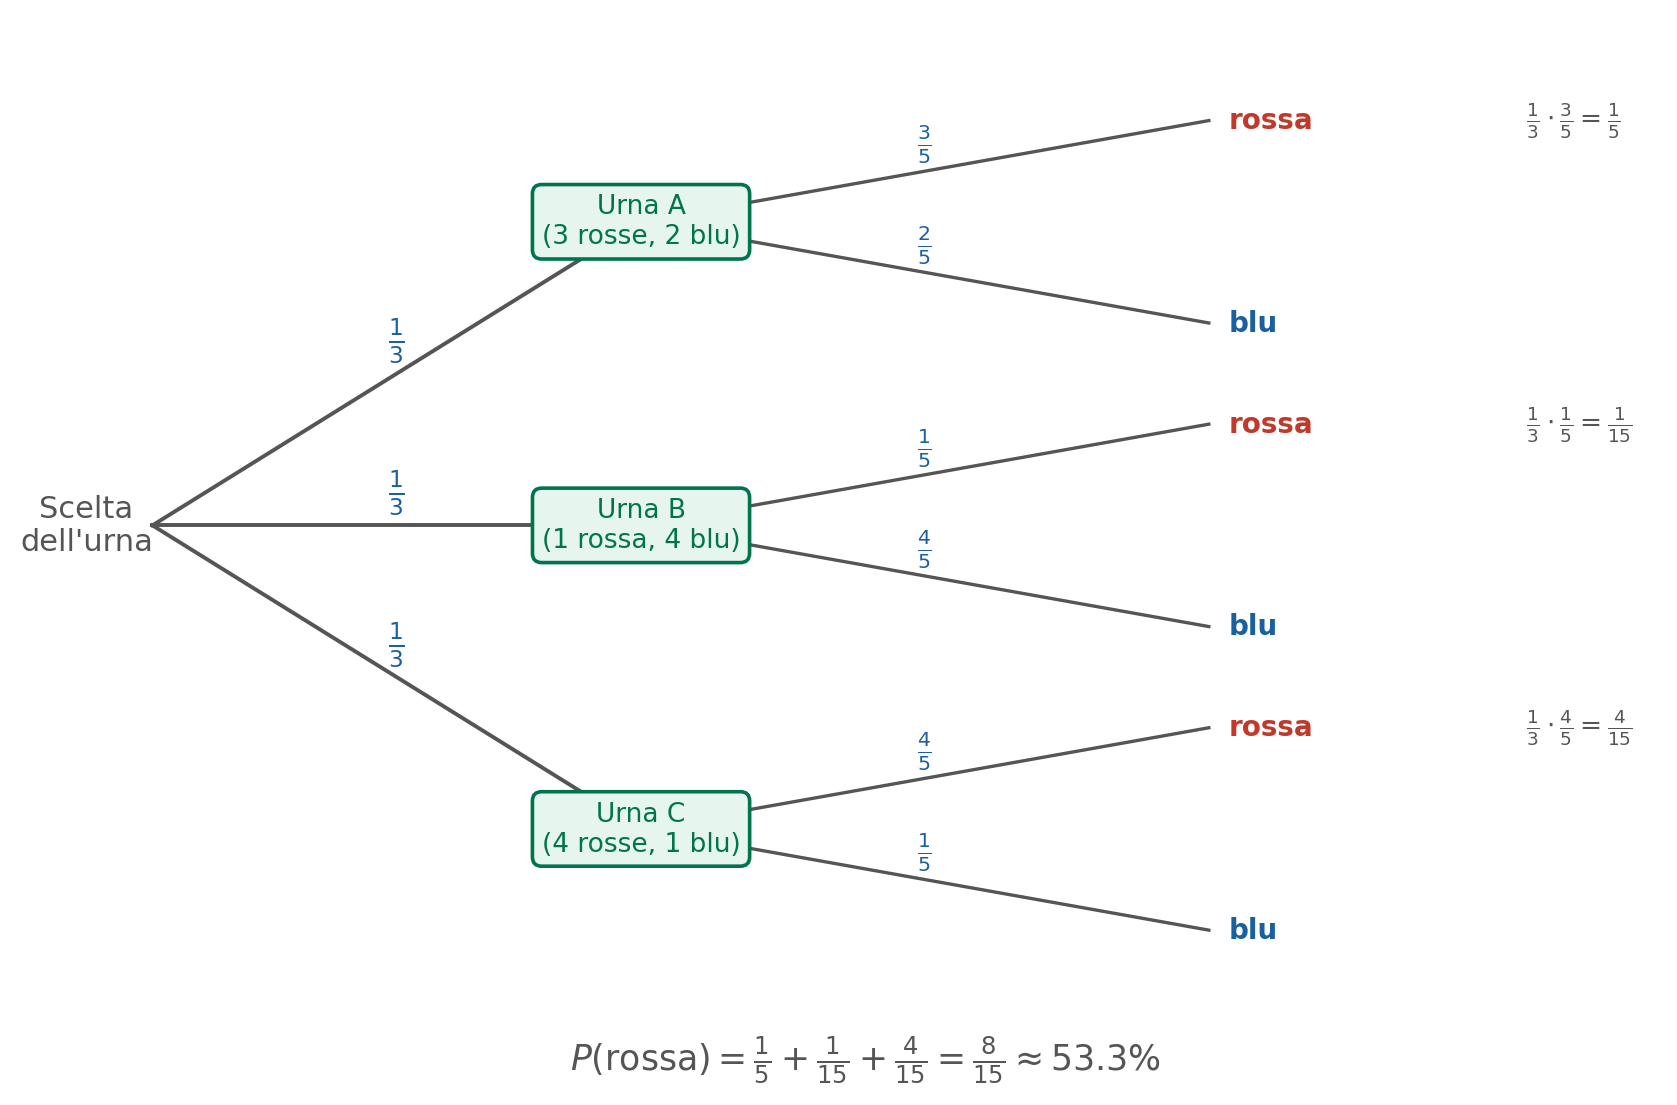
Applicando la formula, sommando i tre contributi (uno per ciascuna urna):
La probabilità composta riguarda il calcolo della probabilità che si verifichino contemporaneamente (o in successione) due eventi \(A\) e \(B\), cioè \(P(A \cap B)\). Il modo di calcolarla dipende da un fatto cruciale: il verificarsi di \(A\) influenza oppure no la probabilità che si verifichi \(B\)?
Eventi indipendenti
Due eventi \(A\) e \(B\) si dicono indipendenti quando il verificarsi (o il non verificarsi) di \(A\) non cambia in alcun modo la probabilità che si verifichi \(B\), e viceversa. Tipicamente questo accade quando \(A\) e \(B\) riguardano esperimenti diversi e separati (ad esempio due lanci di dado distinti), oppure estrazioni con reimmissione (la pallina estratta viene rimessa nell'urna prima dell'estrazione successiva, quindi la composizione dell'urna resta invariata).
In questo caso, la probabilità che si verifichino entrambi gli eventi è semplicemente il prodotto delle due probabilità:
Intuitivamente: se, ad esempio, \(B\) si verifica "1 volta su 3" indipendentemente da cosa succede con \(A\), allora tra i casi in cui si verifica \(A\), ancora solo "1 su 3" farà verificare anche \(B\) — da cui la moltiplicazione delle frazioni di probabilità.
Esempio facile
Si lanciano una moneta e un dado. Qual è la probabilità di ottenere testa e un numero pari?
I due esperimenti (moneta e dado) sono chiaramente indipendenti: il risultato dell'uno non influenza in alcun modo l'altro. \(P(\text{testa}) = \frac{1}{2}\), \(P(\text{pari}) = \frac{3}{6} = \frac{1}{2}\). Quindi
Esempio difficile
Un'urna contiene 5 palline rosse e 3 blu. Si estrae una pallina, se ne annota il colore e la si rimette nell'urna (estrazione con reimmissione); l'operazione viene ripetuta per un totale di 3 estrazioni. Qual è la probabilità di ottenere esattamente 2 palline rosse (in un ordine qualunque) sulle 3 estrazioni?
Poiché c'è reimmissione, le 3 estrazioni sono eventi indipendenti tra loro, con \(P(\text{rossa}) = \frac{5}{8}\) e \(P(\text{blu}) = \frac{3}{8}\) costanti a ogni estrazione. Le 2 estrazioni "rosse" possono capitare in una qualsiasi delle 3 posizioni; quante sono le sequenze possibili con esattamente 2 rosse su 3?
Ogni sequenza ha, per l'indipendenza, probabilità \(\left(\frac{5}{8}\right)^2 \cdot \frac{3}{8}\). Sommando le 3 sequenze (eventi incompatibili tra loro):
Questo tipo di ragionamento — estrazioni ripetute e indipendenti, con reimmissione — è esattamente lo schema su cui si costruisce la distribuzione binomiale, che incontreremo più avanti.
Eventi dipendenti
Se invece il verificarsi di \(A\) modifica la probabilità che si verifichi \(B\), i due eventi si dicono dipendenti. Il caso tipico è quello delle estrazioni senza reimmissione: dopo la prima estrazione, la composizione dell'urna cambia, e quindi cambia anche la probabilità relativa alla seconda estrazione.
In questo caso non possiamo più moltiplicare semplicemente \(P(A)\) e \(P(B)\): dobbiamo usare la probabilità di \(B\) ricalcolata sapendo che \(A\) si è già verificato, indicata con \(P(B \mid A)\) e chiamata probabilità condizionata (la definiremo con precisione nella prossima sezione). La formula generale della probabilità composta è:
Si noti che questa è, in realtà, la formula generale, valida sempre: nel caso particolare di eventi indipendenti si ha \(P(B \mid A) = P(B)\) (sapere che \(A\) si è verificato non cambia la probabilità di \(B\)), e la formula si riduce a quella vista sopra. Nei prossimi esempi calcoliamo \(P(B \mid A)\) "per via diretta", semplicemente ragionando su come cambia la situazione dopo che \(A\) si è verificato.
Esempio facile
Un'urna contiene 5 palline rosse e 3 blu. Si estraggono, senza reimmissione, 2 palline in successione. Qual è la probabilità che siano entrambe rosse?
La probabilità che la prima pallina estratta sia rossa è \(P(A) = \frac{5}{8}\). Se \(A\) si verifica, nell'urna restano 7 palline, di cui 4 rosse: quindi la probabilità che anche la seconda sia rossa, sapendo che la prima lo era, è \(P(B \mid A) = \frac{4}{7}\). Applicando la formula:
Esempio difficile
Da un mazzo di 40 carte si estraggono, senza reimmissione, 3 carte in successione. Qual è la probabilità che siano tutte e tre Assi?
Il mazzo contiene 4 Assi su 40 carte. La probabilità che la prima carta sia un Asso è \(\frac{4}{40}\). Se lo è, restano 39 carte di cui 3 Assi: la probabilità che anche la seconda sia un Asso, condizionata al fatto che la prima lo era, è \(\frac{3}{39}\). Se anche questa si verifica, restano 38 carte di cui 2 Assi: la probabilità che la terza sia un Asso è \(\frac{2}{38}\). Moltiplicando le tre probabilità (condizionate ciascuna al verificarsi delle precedenti):
Si può verificare lo stesso risultato anche per via combinatoria: i casi possibili sono \(\binom{40}{3} = 9880\), i casi favorevoli (i 4 Assi presi 3 alla volta) sono \(\binom{4}{3} = 4\), quindi \(P = \frac{4}{9880} = \frac{1}{2470}\), lo stesso valore. Questo schema — estrazioni ripetute senza reimmissione — è alla base della distribuzione ipergeometrica, che incontreremo più avanti.
Come nasce la probabilità condizionata
Supponiamo di sapere che si è verificato l'evento \(B\), e di voler calcolare, con questa informazione in più, la probabilità che si sia verificato anche \(A\). Indichiamo questa probabilità con \(P(A \mid B)\) (si legge "probabilità di \(A\) dato \(B\)", o "probabilità di \(A\) condizionata da \(B\)").
Per capire come calcolarla, immaginiamo che lo spazio campionario \(\Omega\) sia composto da \(n\) esiti elementari, tutti ugualmente possibili, e dividiamoli in quattro gruppi rispetto ad \(A\) e \(B\): \(r\) esiti appartengono solo ad \(A\) (non a \(B\)), \(s\) esiti appartengono sia ad \(A\) sia a \(B\) (cioè ad \(A \cap B\)), \(t\) esiti appartengono solo a \(B\) (non ad \(A\)), e i restanti esiti non appartengono né ad \(A\) né a \(B\).
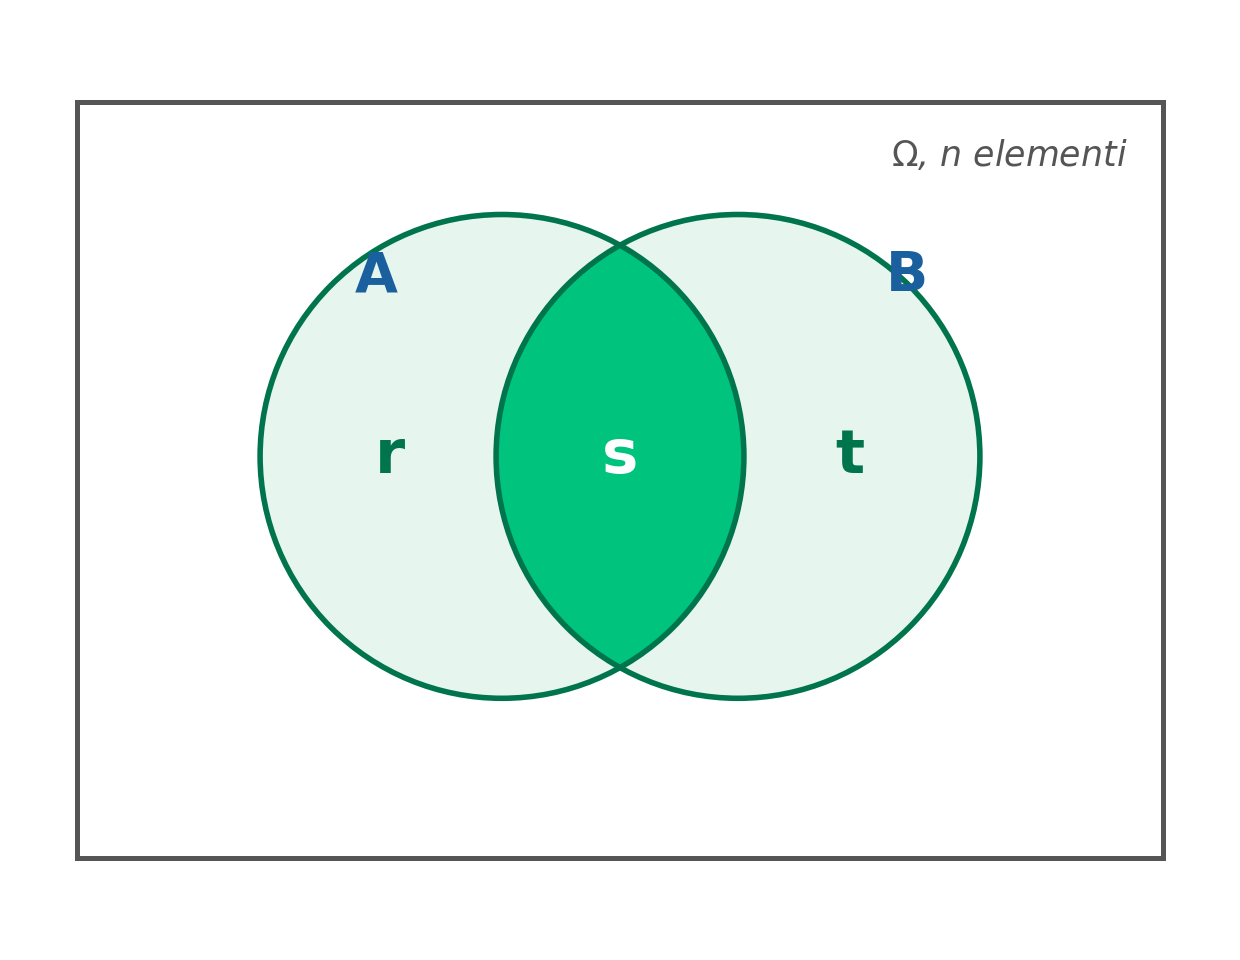
Sapere che \(B\) si è verificato significa che il risultato dell'esperimento è uno degli esiti di \(B\): in altre parole, lo spazio campionario si restringe da \(\Omega\) a \(B\), che contiene \(s + t\) esiti (quelli solo di \(B\), più quelli in comune con \(A\)). Tra questi \(s + t\) esiti "possibili" (ora che sappiamo che siamo dentro \(B\)), quelli "favorevoli" ad \(A\) sono solo gli \(s\) esiti dell'intersezione \(A \cap B\) — gli unici, tra quelli di \(B\), che appartengono anche ad \(A\). Applicando la definizione classica di probabilità al nuovo spazio campionario \(B\):
Ora dividiamo numeratore e denominatore per \(n\) (il numero totale di esiti nello spazio campionario originario \(\Omega\)): il numeratore \(s\) diviso \(n\) è proprio \(P(A \cap B)\) (la frazione di \(\Omega\) che sta in \(A \cap B\)), mentre il denominatore \(s+t\) diviso \(n\) è \(P(B)\) (la frazione di \(\Omega\) che sta in \(B\)):
Arriviamo così alla formula della probabilità condizionata, valida ogni volta che \(P(B) \neq 0\):
In sintesi: calcolare \(P(A \mid B)\) equivale a "dimenticare" tutto ciò che sta fuori da \(B\) e chiedersi, dentro il nuovo mondo \(B\), quale frazione appartiene anche ad \(A\).
Riformulazione della probabilità composta
Moltiplicando entrambi i membri della formula precedente per \(P(B)\), ritroviamo esattamente la formula generale della probabilità composta vista nella sezione precedente:
(Per simmetria tra \(A\) e \(B\), vale anche \(P(A \cap B) = P(B \mid A) \cdot P(A)\): si può condizionare rispetto a uno qualsiasi dei due eventi.)
Test di indipendenza
Ricordando dalla sezione precedente che due eventi sono indipendenti quando il verificarsi dell'uno non cambia la probabilità dell'altro, possiamo ora esprimere questa idea in modo preciso:
cioè: sapere che \(B\) si è verificato non altera la probabilità di \(A\). In questo caso particolare, la formula \(P(A \cap B) = P(A \mid B) \cdot P(B)\) diventa \(P(A \cap B) = P(A) \cdot P(B)\), la formula del prodotto semplice vista per gli eventi indipendenti.
Esempio 1 — Il lancio di un dado (facile)
Si lancia un dado a sei facce. Sapendo che è uscito un numero pari, qual è la probabilità che sia maggiore di 3?
Sia \(B\) = "esce un numero pari" \(= \{2, 4, 6\}\), l'evento di cui sappiamo che si è verificato, e \(A\) = "esce un numero maggiore di 3" \(= \{4, 5, 6\}\), l'evento di cui vogliamo la probabilità condizionata. Restringiamo lo spazio campionario a \(B\): tra i 3 esiti di \(B\), quelli che appartengono anche ad \(A\) sono \(A \cap B = \{4, 6\}\), cioè 2 esiti su 3. Infatti, con la formula:
Esempio 2 — Estrazione di carte
Da un mazzo di 40 carte si estraggono contemporaneamente 2 carte. Sapendo che tra le due c'è almeno un Re, qual è la probabilità che siano entrambe Re?
I casi possibili (coppie di carte) sono \(\binom{40}{2} = 780\). Calcoliamo prima \(P(B)\), con \(B\) = "almeno un Re", passando dal complementare "nessun Re" (entrambe le carte scelte tra le 36 non-Re):
Sia \(A\) = "entrambe le carte sono Re". Poiché avere entrambe Re implica avere "almeno un Re", l'evento \(A\) è già "contenuto" in \(B\), quindi \(A \cap B = A\):
Applicando la formula:
Esempio 3 — Estrazione da un'urna (all'indietro nel tempo)
Un'urna contiene 5 palline rosse e 3 blu. Si estraggono, senza reimmissione, 2 palline in successione. Sapendo che la seconda pallina estratta è rossa, qual è la probabilità che anche la prima fosse rossa?
Questo esempio è interessante perché condizioniamo su un evento (la seconda estrazione) che accade dopo l'evento di cui vogliamo la probabilità (la prima estrazione): la probabilità condizionata non richiede necessariamente un ordine cronologico "in avanti".
Calcoliamo prima \(P(A \cap B)\), con \(A\) = "prima rossa" e \(B\) = "seconda rossa": dopo aver estratto una rossa, restano 4 rosse su 7, quindi
Per calcolare \(P(B)\), consideriamo le due possibilità per la prima estrazione: "prima rossa, poi rossa" oppure "prima blu, poi rossa" (dopo una blu restano 5 rosse su 7 palline rimaste):
Curiosamente, \(P(B) = \frac{5}{8}\), esattamente come \(P(\text{prima rossa})\): per simmetria, la probabilità che una data estrazione sia rossa non dipende dalla sua posizione nella sequenza. Applicando ora la formula:
Si noti che \(\frac{4}{7}\) è anche il valore di \(P(\text{seconda rossa} \mid \text{prima rossa})\), calcolato nella Sezione 4: una simmetria che non è un caso, ma che esula dagli scopi di questa pagina introduttiva.
Esempio 4 — Tabella a doppia entrata: dati anagrafici (difficile)
In una scuola di 200 studenti, 90 sono maschi e 110 sono femmine. Tra i maschi, 54 praticano uno sport; tra le femmine, 55 praticano uno sport. Si sceglie a caso uno studente. Sapendo che è un maschio, qual è la probabilità che pratichi uno sport? E, viceversa, sapendo che lo studente pratica uno sport, qual è la probabilità che sia un maschio?
Organizziamo i dati in una tabella a doppia entrata — è esattamente la "fotografia numerica" del diagramma \(r, s, t\) visto sopra, dove \(A\) = "pratica uno sport" e \(B\) = "è maschio":
| Maschi | Femmine | Totale | |
|---|---|---|---|
| Sport | 54 | 55 | 109 |
| Non sport | 36 | 55 | 91 |
| Totale | 90 | 110 | 200 |
Prima domanda: \(P(\text{sport} \mid \text{maschio})\). Restringiamo lo spazio campionario ai soli maschi (90 studenti): tra questi, 54 praticano sport.
Seconda domanda: \(P(\text{maschio} \mid \text{sport})\). Restringiamo lo spazio campionario ai soli studenti che praticano sport (\(54 + 55 = 109\) studenti): tra questi, 54 sono maschi.
I due risultati sono chiaramente diversi (\(60\%\) contro circa \(49.5\%\)): questo conferma che \(P(A \mid B)\) e \(P(B \mid A)\) sono, in generale, due probabilità differenti — confonderle è un errore concettuale piuttosto comune, quindi vale la pena tenerlo bene a mente.
«Aggiornare le proprie opinioni alla luce di nuove prove»: è così che si potrebbe riassumere, in una frase, il senso profondo del teorema di Bayes.
Nella sezione precedente abbiamo visto, con l'esempio della tabella maschi/femmine e sport, che \(P(A \mid B)\) e \(P(B \mid A)\) sono in generale due probabilità diverse. Il teorema di Bayes risponde esattamente a questo tipo di domanda: quando conosciamo (o sappiamo calcolare) \(P(A \mid B_i)\) per ciascuno scenario \(B_i\) — cioè conosciamo la probabilità dell'"effetto" \(A\) in ogni possibile "causa" \(B_i\) — ma vogliamo invece \(P(B_i \mid A)\): la probabilità che, osservato l'effetto \(A\), esso sia stato prodotto proprio dalla causa \(B_i\). In altre parole, il teorema di Bayes permette di "invertire" il condizionamento e di ragionare all'indietro, dagli effetti alle cause.
Come si ricava la formula
Il punto di partenza è la riformulazione della probabilità composta, vista nella sezione precedente, applicata due volte allo stesso evento \(B_i \cap A\) — scambiando i ruoli di "condizione" e "condizionato":
Isolando \(P(B_i \mid A)\) nei due membri esterni dell'uguaglianza:
A questo punto, se \(B_1, B_2, \dots, B_n\) formano una partizione di \(\Omega\) (come nella sezione precedente), possiamo esprimere \(P(A)\) al denominatore usando il teorema della probabilità totale. Otteniamo così la formula di Bayes nella sua versione completa:
Il denominatore, come già visto, è semplicemente \(P(A)\): la formula di Bayes si scrive quindi anche, più sinteticamente, come \(P(B_i \mid A) = \dfrac{P(B_i) \cdot P(A \mid B_i)}{P(A)}\) — a patto di saper calcolare \(P(A)\) con la probabilità totale.
Anche qui l'albero delle probabilità resta lo strumento guida più utile: lo si costruisce "in avanti" (dalle cause \(B_i\) agli effetti, con le probabilità note), poi per applicare Bayes si leggono i risultati "all'indietro" — dal ramo che porta all'effetto osservato, si risale a quale causa lo ha prodotto con quale probabilità.
Esempio facile — Le tre urne, all'indietro
Riprendiamo le tre urne della sezione precedente (urna A: 3 rosse, 2 blu; urna B: 1 rossa, 4 blu; urna C: 4 rosse, 1 blu, scelte con la stessa probabilità \(\frac{1}{3}\)). Questa volta supponiamo di sapere che la pallina estratta è risultata rossa. Qual è la probabilità che provenga dall'urna B?
Riusiamo esattamente lo stesso albero calcolato nella sezione precedente (i rami "in avanti" non cambiano):
Applichiamo la formula di Bayes per \(B_i = B\) (l'urna B), usando al denominatore \(P(\text{rossa}) = \frac{8}{15}\), già calcolato nella sezione precedente:
Interessante: la probabilità a priori di aver scelto l'urna B era \(\frac{1}{3} \approx 33.3\%\), ma sapendo che è uscita una pallina rossa (evento raro per l'urna B, che ne contiene solo 1 su 5), questa probabilità scende drasticamente a \(12.5\%\). Per completezza, con lo stesso procedimento si trova \(P(A \mid \text{rossa}) = \frac{3}{8} = 37.5\%\) e \(P(C \mid \text{rossa}) = \frac{1}{2} = 50\%\): la spiegazione più probabile, avendo osservato una pallina rossa, è che provenga dall'urna C — quella con più palline rosse. Si noti che, come deve essere, \(\frac{3}{8} + \frac{1}{8} + \frac{4}{8} = 1\): le tre probabilità "all'indietro" si ridistribuiscono sempre su un totale di 1.
Esempio difficile — Un test diagnostico
Una malattia colpisce l'1% della popolazione. Esiste un test diagnostico che individua correttamente la malattia nel 95% dei casi in cui è presente (sensibilità), ma dà anche un risultato positivo, per errore, nel 3% dei casi in cui la persona è sana (falso positivo). Una persona si sottopone al test e risulta positiva. Qual è la probabilità che sia realmente malata?
Indichiamo con \(M\) = "la persona è malata" e con \(+\) = "il test risulta positivo". Sono dati: \(P(M) = \frac{1}{100}\), \(P(\overline{M}) = \frac{99}{100}\), \(P(+ \mid M) = \frac{95}{100}\), \(P(+ \mid \overline{M}) = \frac{3}{100}\). Costruiamo l'albero delle probabilità:
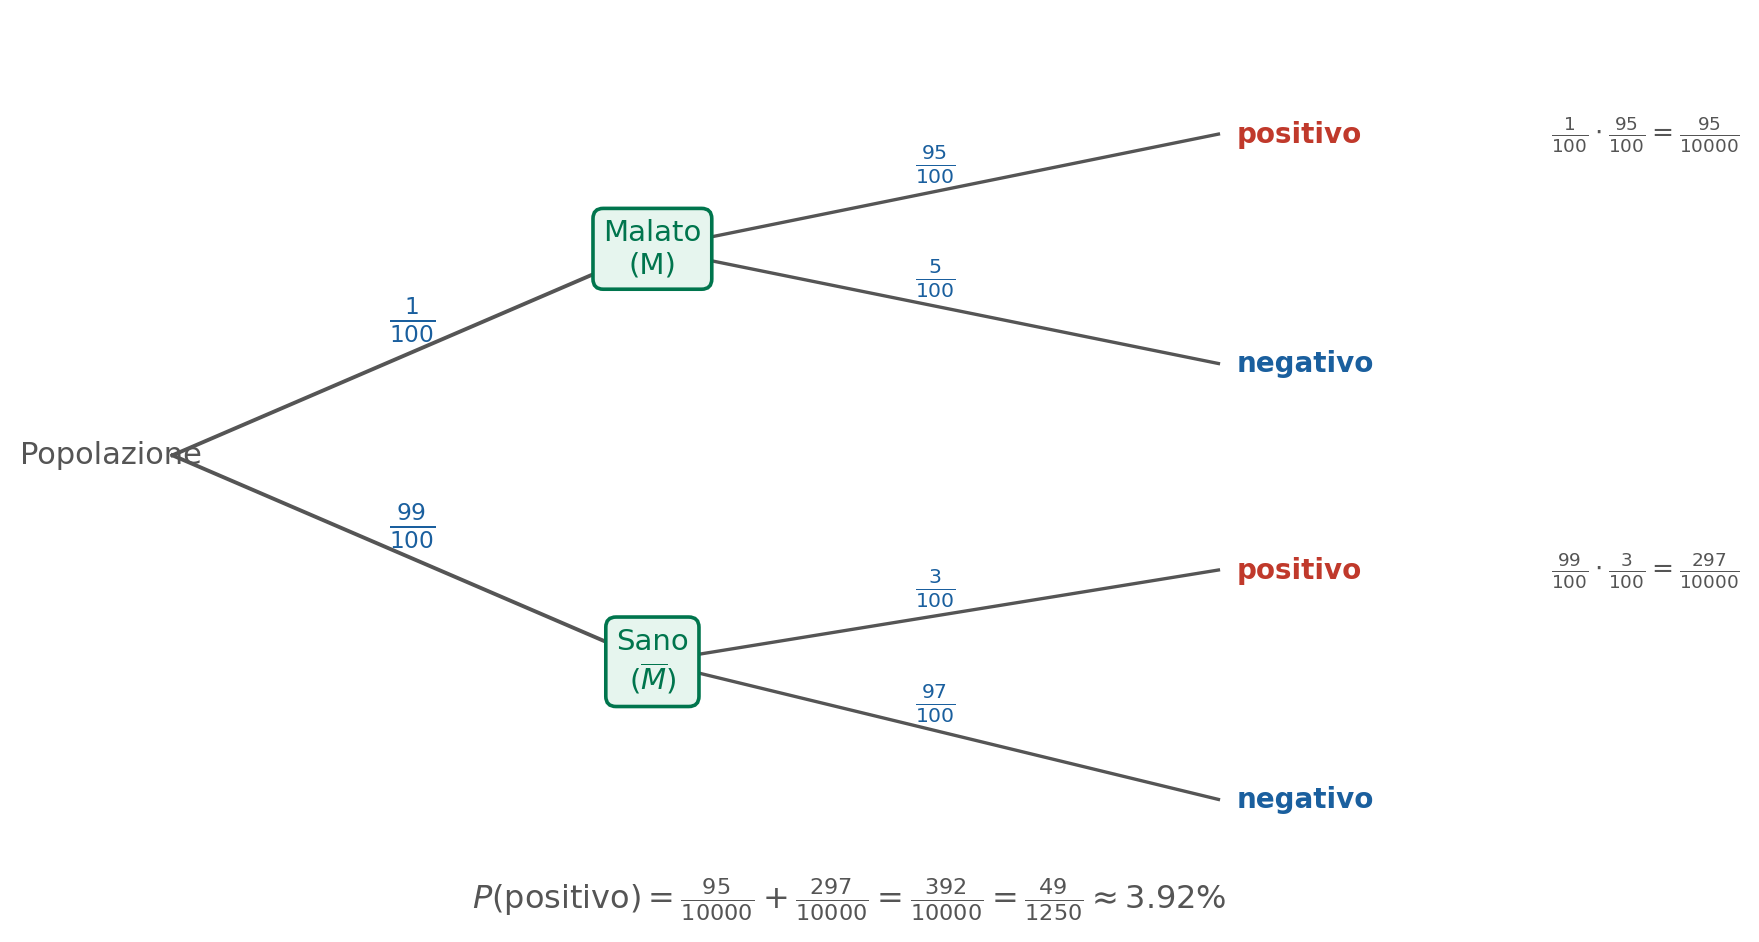
Calcoliamo prima \(P(+)\) con la probabilità totale (somma dei due percorsi che portano a un test positivo):
Applichiamo ora la formula di Bayes:
Il risultato sorprende quasi sempre chi lo vede per la prima volta: nonostante il test sia accurato al 95% (sensibilità) e sbagli solo nel 3% dei casi sui sani, una persona positiva ha in realtà meno del 25% di probabilità di essere davvero malata! Questo accade perché la malattia è rara (\(1\%\)): tra tutti i positivi, la grande maggioranza proviene dal grande gruppo dei sani (il 3% di errore su una popolazione enorme di sani supera il 95% di veri positivi su una popolazione ristretta di malati). È proprio questo il tipo di ragionamento — spesso controintuitivo — che il teorema di Bayes permette di formalizzare correttamente.
Esempio — Rilevamento frodi con carta di credito
Un sistema antifrode analizza automaticamente le transazioni con carta di credito. Si stima che solo lo 0,1% delle transazioni sia realmente fraudolento. Il sistema individua correttamente il 90% delle transazioni fraudolente, ma segnala come "sospette", per errore, anche il 2% delle transazioni regolari. Una transazione viene segnalata come sospetta: qual è la probabilità che sia davvero una frode?
Indichiamo con \(F\) = "la transazione è una frode" e con \(S\) = "la transazione è segnalata come sospetta". Sono dati: \(P(F) = \frac{1}{1000}\), \(P(\overline{F}) = \frac{999}{1000}\), \(P(S \mid F) = \frac{9}{10}\), \(P(S \mid \overline{F}) = \frac{1}{50}\).
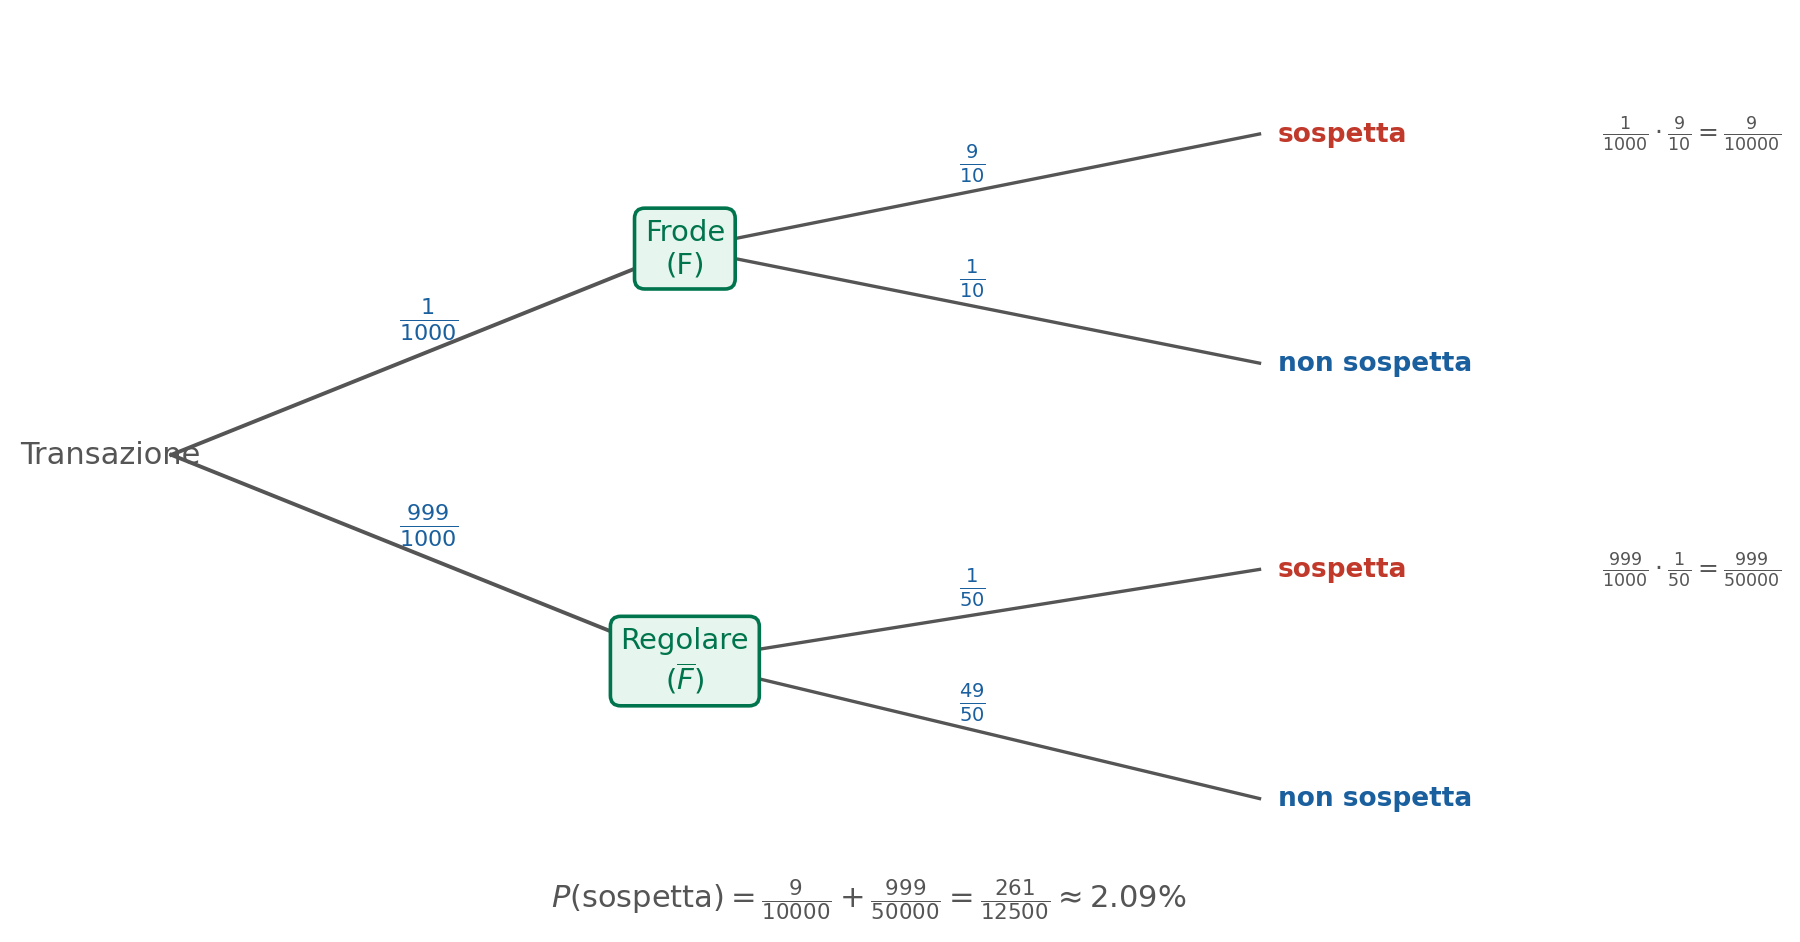
Calcoliamo \(P(S)\) con la probabilità totale:
Applichiamo Bayes:
Anche qui il risultato è controintuitivo: nonostante il sistema individui il 90% delle frodi, solo circa il 4% delle transazioni segnalate come sospette è realmente fraudolento! Il motivo è lo stesso del test diagnostico: le frodi sono rarissime (\(0,1\%\)), quindi anche un tasso di falsi positivi piccolo (2%) genera, in valore assoluto, molte più segnalazioni "sbagliate" che segnalazioni "giuste". È per questo che i sistemi antifrode reali non bloccano automaticamente ogni transazione sospetta, ma la sottopongono a ulteriori controlli.
Esempio — Controllo qualità in una fabbrica
Una fabbrica produce pezzi meccanici su due linee di produzione: la linea A (più vecchia) realizza il 40% della produzione totale, con una percentuale di difettosità del 5%; la linea B (più nuova) realizza il restante 60%, con una percentuale di difettosità dell'1%. Si sceglie a caso un pezzo dalla produzione complessiva e risulta difettoso. Qual è la probabilità che provenga dalla linea A?
Indichiamo con \(A\) = "il pezzo proviene dalla linea A", \(B\) = "il pezzo proviene dalla linea B" (una partizione: ogni pezzo viene da una e una sola linea), e \(D\) = "il pezzo è difettoso". Sono dati: \(P(A) = \frac{4}{10}\), \(P(B) = \frac{6}{10}\), \(P(D \mid A) = \frac{5}{100}\), \(P(D \mid B) = \frac{1}{100}\).
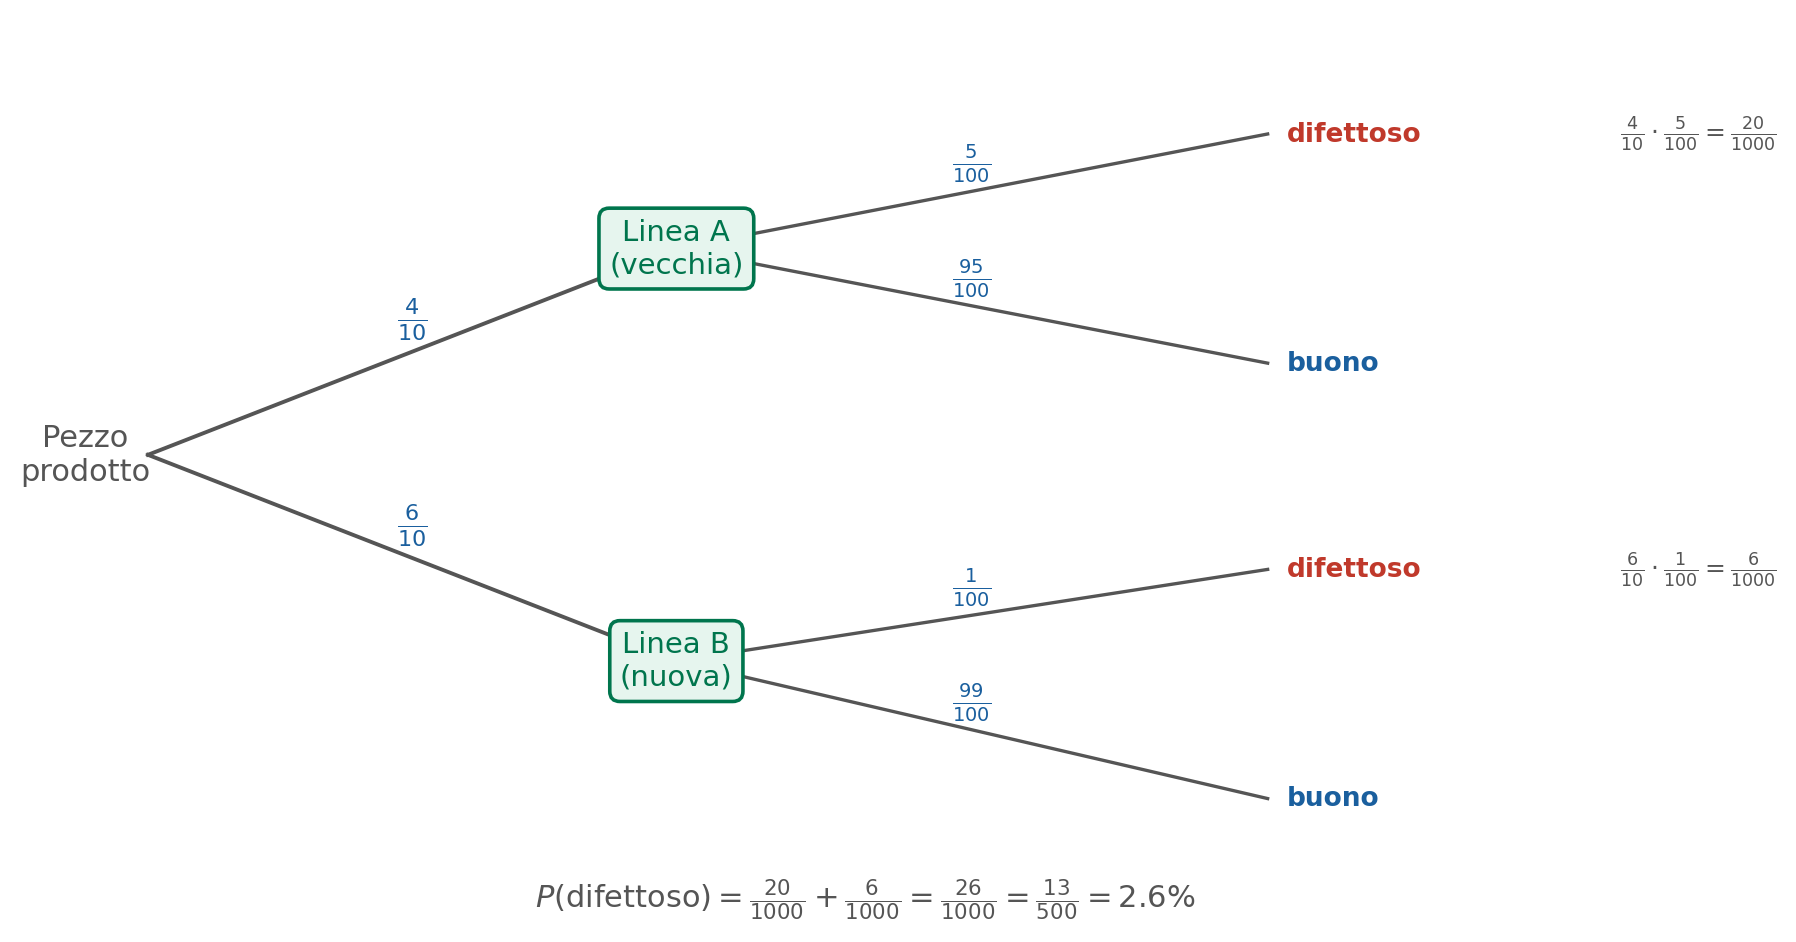
Calcoliamo \(P(D)\) con la probabilità totale:
Applichiamo Bayes:
Nonostante la linea A produca solo il 40% dei pezzi totali (meno della metà), un pezzo difettoso proviene da essa con probabilità quasi del 77%! Questo perché la sua percentuale di difettosità (5%) è cinque volte più alta di quella della linea B (1%): pur producendo meno pezzi in assoluto, la linea A "contribuisce" in modo sproporzionato al totale dei pezzi difettosi. Un responsabile qualità, osservando questo dato, saprebbe subito dove concentrare i controlli e gli interventi di manutenzione.
Come richiamato all'inizio della pagina, la probabilità classica e quella frequentista non bastano a coprire tutte le situazioni in cui parliamo di probabilità nella vita reale. Quanto è probabile che una certa squadra vinca il prossimo campionato? Che un'impresa abbia successo? Che piova domani in un luogo dove non esistono dati storici affidabili? Non ci sono "casi possibili" da contare, né esperimenti ripetibili nelle stesse condizioni: eppure ha senso parlare di probabilità, come grado di fiducia personale nel verificarsi dell'evento.
La probabilità soggettiva secondo de Finetti
Il matematico italiano Bruno de Finetti (1906-1985) ha dato a questa idea una definizione operativa precisa, legandola al concetto di scommessa coerente. L'idea è questa: la probabilità soggettiva che una persona attribuisce a un evento \(E\) è il prezzo \(p\) (tra 0 e 1, per ogni euro in palio) che quella persona considera equo pagare per ricevere 1 euro se \(E\) si verifica, e nulla altrimenti — con la condizione che sia disposta indifferentemente a stare da entrambe le parti della scommessa (sia a pagare \(p\) per comprare la scommessa, sia ad accettare \(p\) per venderla). Questa doppia disponibilità è cruciale: se una persona fosse disposta a vendere a un prezzo ma non a comprare allo stesso prezzo, le sue valutazioni sarebbero "sbilanciate" e qualcun altro potrebbe sfruttarle a proprio vantaggio garantito — una situazione che de Finetti chiama incoerente.
Un insieme di probabilità soggettive è coerente quando rispetta gli stessi assiomi della probabilità classica (\(0 \leq P(E) \leq 1\), \(P(\Omega) = 1\), l'additività per eventi incompatibili, ecc.): se non li rispetta, è sempre possibile costruire una combinazione di scommesse che garantisce una perdita certa a chi le ha proposte, indipendentemente da come va a finire l'evento.
Una formulazione equivalente, spesso usata perché più diretta: se \(S\) è la somma scommessa e \(V\) è quanto si incassa complessivamente in caso di vittoria (puntata inclusa), la probabilità soggettiva coerente è
È solo un altro modo di guardare alla stessa idea: in media, l'incasso \(V\) pesato per la probabilità di vincita \(p\) deve eguagliare la somma versata \(S\), cioè \(p \cdot V = S\).
Il gioco equo
Il concetto di scommessa coerente si collega direttamente a quello di gioco equo: un gioco (o una scommessa) si dice equo quando nessuno dei due partecipanti ha, in media, un vantaggio sull'altro. Per un gioco con due soli esiti — vincita di \(V\) euro con probabilità \(p\), oppure pagamento di una quota \(C\) con probabilità \(1-p\) — la condizione di equità è che il "guadagno atteso" dei due partecipanti si bilanci esattamente:
Il membro di sinistra rappresenta, in un certo senso, quanto "vale" mediamente la vincita per chi scommette; il membro di destra quanto "vale" mediamente la posta per chi la incassa se l'evento non si verifica. Se i due si bilanciano, nessuno dei due ha un vantaggio sistematico.
Esempio 1 — Costruire un gioco equo (facile)
Si lancia un dado a sei facce. Se esce 6 si vince \(V = 60\) euro; altrimenti si paga una quota fissa \(C\). Quanto deve valere \(C\) perché il gioco sia equo?
La probabilità di vincere è \(p = \frac{1}{6}\) (probabilità classica), quella di non vincere è \(1 - p = \frac{5}{6}\). Imponendo la condizione di equità:
La quota da pagare in caso di mancata vincita deve essere di 12 euro. Si noti che \(C < V\): è naturale, dato che perdere è molto più probabile (\(\frac{5}{6}\)) che vincere (\(\frac{1}{6}\)), quindi la posta in gioco in caso di perdita dev'essere proporzionalmente più piccola della vincita.
Esempio 2 — Dalla quota di scommessa alla probabilità implicita
Un allibratore propone una quota "3 contro 1" sulla vittoria di una squadra A in una partita: scommettendo 1 euro, se A vince se ne ricevono 3 (oltre alla propria posta), se A non vince si perde l'euro scommesso. Qual è la probabilità soggettiva di vittoria di A, implicita in questa quota, perché la scommessa sia equa?
Indichiamo con \(p\) la probabilità (implicita, incognita) che A vinca. La condizione di equità, con \(V = 3\) (la vincita per ogni euro puntato) e \(C = 1\) (la posta persa), dà:
Questo è, in generale, il modo in cui si "leggono" le quote di scommessa: una quota \(a\) contro \(b\) corrisponde a una probabilità implicita \(p = \dfrac{b}{a+b}\) (qui \(\frac{1}{3+1} = \frac{1}{4}\), coerentemente).
Esempio 3 — Coerenza: quando le probabilità soggettive "non tornano" (difficile)
Per la stessa partita, un allibratore quota le tre possibili conclusioni — vittoria di A, pareggio, vittoria di B — con probabilità soggettive implicite rispettivamente del 45%, 30% e 20%. Queste valutazioni sono coerenti, nel senso di de Finetti?
I tre esiti (vittoria di A, pareggio, vittoria di B) sono incompatibili e la loro unione è l'evento certo: formano cioè una partizione dello spazio campionario, esattamente come quelle viste nella Sezione 3. Per la coerenza, le tre probabilità dovrebbero quindi sommare a 1 (cioè al 100%). Sommiamo:
Le probabilità non sono coerenti: mancano 5 punti percentuali all'appello. Con una somma inferiore a 100%, esisterebbe una combinazione di scommesse sui tre esiti che garantirebbe una vincita certa allo scommettitore, qualunque sia il risultato della partita — situazione svantaggiosa per l'allibratore. Non a caso, un allibratore reale fa esattamente l'opposto: fissa le quote in modo che la somma delle probabilità implicite superi leggermente il 100% (il cosiddetto "aggio" del banco), così da garantirsi un margine di profitto sistematico, indipendentemente da come va a finire la partita. È comunque un caso di incoerenza (le probabilità non sommano esattamente a 1), ma stavolta a vantaggio di chi propone le quote piuttosto che di chi scommette: è proprio questo il motivo per cui una valutazione di probabilità le cui parti non sommano esattamente a 1 va sempre analizzata con attenzione, per capire a favore di chi gioca lo squilibrio.